แก่นของเรื่อง
แนวคิดหลัก. LLM ตัวเดียวตอบได้ครั้งเดียวแล้วจบ ส่วน AI employee คือ LLM ที่วนลูป Goal, Context, Plan, Act, Verify, Learn ซ้ำจนงานเสร็จ โดยแต่ละรอบใช้เครื่องมือจริง ตรวจผลจริง และจดสิ่งที่เรียนรู้ไว้ให้รอบหน้า ความต่างจากแชตบอตอยู่ที่ลูปนี้ ไม่ได้อยู่ที่ขนาดโมเดล
ทำไมถึงได้ผล. แต่ละขั้นปิดจุดอ่อนของ LLM หนึ่งอย่าง: Goal กับ Plan กันการทำงานไร้ทิศ, Context กันการเดาโดยไม่มีข้อมูล, Act ให้ผลกระทบจริง, Verify เปลี่ยน "ดูน่าจะถูก" เป็น "ตรวจแล้ว" ด้วยหลักฐานภายนอก, Learn กับ Memory กันการพลาดซ้ำ ถ้าตัดขั้นใดออก ลูปจะรั่วที่ขั้นนั้น เช่นไม่มี Verify ความผิดพลาดจะสะสมทุกรอบโดยไม่มีใครรู้
20% ที่สำคัญที่สุดในทางปฏิบัติ (ตีความ ภาพไม่ได้จัดลำดับความสำคัญ):
| ลำดับ | สิ่งที่ต้องมี | เหตุผล |
|---|---|---|
| ทำก่อน | เป้าหมายที่วัดได้ + เงื่อนไขหยุด (จำนวนรอบสูงสุด, งบ, เวลา) | ไม่มีสองอย่างนี้ agent จะวนไม่จบหรือไม่รู้ว่าเสร็จแล้ว |
| ทำก่อน | Verify ที่ใช้หลักฐานภายนอก (test, schema, เทียบแหล่งอื่น) | เป็นขั้นเดียวที่จับความผิดพลาดก่อนถึงผู้ใช้ |
| ทำต่อ | Tool ที่จำกัดสิทธิ์ และจุดให้คนอนุมัติก่อนทำสิ่งที่ย้อนไม่ได้ | ความเสียหายต่อครั้งมาจากขั้น Act |
| รอได้ | Memory ระยะยาวแบบเต็มรูป | เริ่มจากไฟล์บันทึกบทเรียนสั้น ๆ ก็พอ ค่อยขยายเมื่อมีข้อมูลสะสม |
ช่วยให้ดีขึ้นอย่างไร
ภาพไม่มีตัวเลขวัดผลเลย ทุกแถวด้านล่างจึงเป็นเชิงคุณภาพ และไม่มีแถวไหนติดป้าย วัดแล้ว
| สถานการณ์ | ไม่ใช้ลูปนี้ | ใช้ลูปนี้ | วัดอย่างไร | หลักฐาน |
|---|---|---|---|---|
| งานซ้ำที่ต้องมีคนสั่งทุกครั้ง | คนเริ่มงานเองทุกรอบ | ทำเองตามเวลาหรือเมื่อมีเหตุการณ์ | จำนวนครั้งต่อสัปดาห์ที่คนต้องเริ่มงาน | ตีความ (ภาพระบุเป้าว่า "works while you sleep" ยังไม่มีตัวเลข) |
| ความผิดพลาดหลุดถึงผู้ใช้ | ผลลัพธ์ออกไปโดยไม่มีใครตรวจ | ขั้น Verify ตีกลับผลที่ไม่ผ่านก่อนส่ง | สัดส่วนผลลัพธ์ที่ถูกตีกลับก่อนส่ง และสัดส่วนที่ผู้ใช้แก้ภายหลัง | ยังไม่ทดสอบ (ภาพระบุว่าช่วย "improve reliability" ไม่บอกขนาด) |
| พลาดเรื่องเดิมซ้ำ | ทุกรอบเริ่มจากศูนย์ | บทเรียนถูกจดและดึงมาเป็นบริบทรอบถัดไป | จำนวนข้อผิดพลาดชนิดเดียวกันต่อสัปดาห์ | ยังไม่ทดสอบ |
| ต้นทุนและความเสี่ยงต่อรอบ | ต่ำ ทำนายได้ | สูงขึ้น หลายรอบ หลายการเรียกเครื่องมือ ความผิดพลาดทบกันได้ | ต้นทุนต่องาน, จำนวนรอบเฉลี่ย, อัตรางานที่ต้องให้คนช่วย | ตีความ (Anthropic ระบุต้นทุนสูงกว่า ผิดทบกันได้ ไม่มีตัวเลข) |
Note แถวสุดท้ายคือด้านลบ ลูปนี้แลกความอัตโนมัติกับต้นทุนและความเสี่ยงที่ควบคุมได้ยากขึ้น จึงต้องมีเงื่อนไขหยุดและการติดตามต้นทุนตั้งแต่ต้น
ลองใช้
ตัวอย่างประกอบ: คัดแยก ticket ซัพพอร์ต
ตัวเลขทั้งหมดเป็นสมมติของเรา ไม่ได้มาจากภาพ
| รายการ | ค่า | วิธีคำนวณ |
|---|---|---|
| ticket ต่อวัน | 120 | สมมติ |
| เวลาคนทำเองต่อ ticket (นาที) | 4 | สมมติ |
| เวลารวมถ้าคนทำเองทั้งหมด (นาที) | 480 | 120 x 4 |
| สัดส่วนที่ Verify ติดธง ให้คนดู | 15% | สมมติ |
| จำนวน ticket ที่คนดู | 18 | 120 x 0.15 |
| เวลาคนดูต่อ ticket ที่ติดธง (นาที) | 3 | สมมติ |
| เวลาคนรวมเมื่อใช้ agent (นาที) | 54 | 18 x 3 |
| เวลาที่ประหยัด (นาที) | 426 | 480 - 54 |
| สัดส่วนที่ประหยัด | 88.75% | 426 / 480 |
ลูปของตัวอย่างนี้:
| ขั้น | ในตัวอย่าง |
|---|---|
| Goal | ตอบทุก ticket ภายใน 2 ชั่วโมง ผิดไม่เกิน 3% ตอบเฉพาะหมวดที่อนุญาต |
| Context | ประวัติลูกค้า, ข้อความ ticket, เอกสารนโยบาย (ตัดส่วนที่ไม่เกี่ยวออก) |
| Plan | จัดหมวด, หาคำตอบจากนโยบาย, ร่างคำตอบ |
| Act | เรียก API ของระบบ ticket เพื่ออ่านและร่างคำตอบ (ยังไม่ส่ง) |
| Verify | เทียบคำตอบกับนโยบาย, ตรวจว่าไม่มีข้อมูลลูกค้ารายอื่น, ติดธงถ้าไม่มั่นใจ |
| Learn | จด ticket ที่คนแก้คำตอบ พร้อมสาเหตุ เพื่อใช้เป็นบริบทรอบหน้า |
เมื่อไรควรใช้
| เงื่อนไข | ใช้ AI employee | อย่าเพิ่งใช้ |
|---|---|---|
| ขั้นตอนของงาน | คาดเดาจำนวนขั้นล่วงหน้าไม่ได้ | ขั้นตอนคงที่ ใช้ workflow ธรรมดาถูกและเสถียรกว่า |
| ผลลัพธ์ตรวจได้หรือไม่ | มี test, กฎ หรือแหล่งอ้างอิงตรวจอัตโนมัติ | ตรวจได้เฉพาะด้วยความรู้สึกของคน |
| ความเสียหายถ้าพลาด | ย้อนกลับได้ หรือมีคนอนุมัติก่อนทำ | ย้อนกลับไม่ได้และไม่มีจุดอนุมัติ (ส่งเงิน, ลบข้อมูล) |
| ปริมาณงาน | ซ้ำบ่อย คุ้มค่าตั้งระบบ | ทำปีละไม่กี่ครั้ง |
| สิ่งที่ต้องมีก่อน | เป้าหมายวัดได้, สิทธิ์ tool จำกัด, บันทึก log | ยังเขียนเกณฑ์สำเร็จไม่ได้ |
ก้าวแรกที่เล็กที่สุด
- เลือกงานซ้ำ 1 อย่างที่ตรวจผลได้ เขียน Goal พร้อมเกณฑ์สำเร็จ 1 ประโยค
- ตั้งเงื่อนไขหยุดก่อนรันครั้งแรก เช่น สูงสุด 10 รอบต่องาน หยุดเมื่อ Verify ไม่ผ่านติดกัน 3 ครั้ง แล้วส่งให้คน
- รันในโหมดร่างเท่านั้น (agent เสนอ คนอนุมัติ) 1 สัปดาห์ พร้อมบันทึกทุกรอบ
การทดสอบว่าช่วยจริง
| รายการ | ค่าที่ต้องกำหนดก่อนรัน |
|---|---|
| Baseline | นาทีของคนต่อวัน และอัตราผลที่ถูกแก้ภายหลัง (ย้อนหลัง 1 สัปดาห์) |
| เกณฑ์ผ่าน | นาทีของคนลดลงอย่างน้อย 50% และอัตราผลที่ถูกแก้ภายหลังไม่สูงกว่า baseline |
| เกณฑ์ไม่ผ่าน | ต้นทุนต่องานสูงกว่าคนทำเอง หรืออัตราแก้ภายหลังสูงกว่า baseline |
เกณฑ์ 50% เป็นค่าเริ่มต้นของเรา ปรับตามงานได้ แต่ต้องตั้งก่อนรัน
ทดสอบความเข้าใจ
| คำถาม | คำตอบ | คำตอบที่มักผิด |
|---|---|---|
| agent เขียนโค้ดเสร็จ แล้วให้โมเดลตัวเดิมตอบว่า "ดูถูกต้อง" นับเป็น Verify ไหม | ไม่แข็งพอ ต้องมีหลักฐานภายนอก เช่นรัน test, ตรวจ schema, เทียบกับแหล่งอื่น | "นับ เพราะมีขั้นตรวจแล้ว" |
| Verify ไม่ผ่านติดกัน 3 รอบ ควรทำอย่างไร | หยุดตามเงื่อนไขหยุด บันทึกสาเหตุ แล้วส่งให้คน | "ลองใหม่ต่อจนผ่าน" |
| ข้อมูลใน memory ขัดกับสถานะที่ tool อ่านได้วันนี้ เชื่ออะไร | เชื่อสถานะปัจจุบันจาก tool แล้วแก้หรือลบรายการใน memory | "เชื่อ memory เพราะเรียนรู้มาแล้ว" |
| งานต้องส่งอีเมลหาลูกค้าจริง จะวาง Verify ไว้หลัง Act พอไหม | ไม่พอ ส่งแล้วย้อนไม่ได้ ต้องมีจุดอนุมัติหรือตรวจก่อน Act | "พอ เพราะตรวจหลังส่งแล้วแก้ได้" |
| ในแผนภาพ ลูกศรจาก Learn ไปที่ Context ไม่ไปที่ Act หมายความว่าอะไร | สิ่งที่เรียนรู้เข้า memory แล้วถูกดึงมาเป็นบริบทของรอบถัดไป | "Learn คือการ fine-tune โมเดลทันที" |
| ต้องเปลี่ยนรูปแบบไฟล์ 50 ไฟล์ตามกฎตายตัว ควรใช้ agent หรือไม่ | ไม่จำเป็น ขั้นตอนคาดเดาได้ ใช้สคริปต์หรือ workflow ถูกและเสถียรกว่า | "ใช้ agent เสมอ เพราะฉลาดกว่า" |
ภาพต้นทางและสิ่งที่อ่านได้
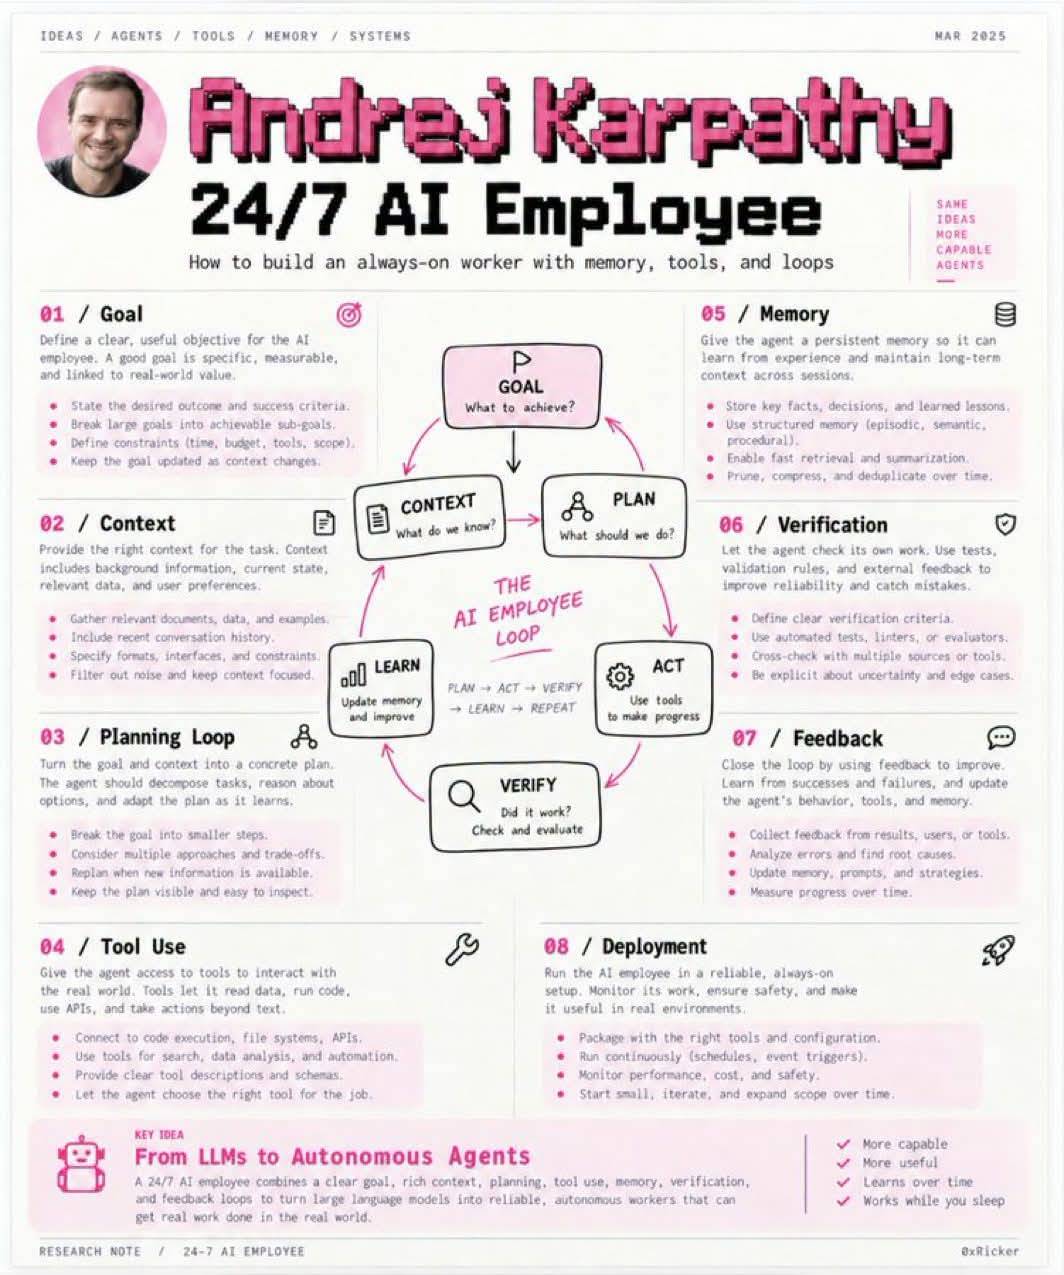
อ่านข้อความในภาพได้ครบ ยกเว้นตัวอักษรเล็กมากที่ท้ายภาพซึ่งไม่ใช่เนื้อหา ไม่มีตัวเลข กราฟ หรือตารางข้อมูล
| ประเภท | รายการ |
|---|---|
| เห็นโดยตรง | 8 กล่องหมายเลข 01 ถึง 08 แต่ละกล่องมีคำอธิบาย 1 ประโยคและหัวข้อย่อย 4 ข้อ |
| เห็นโดยตรง | วงกลางมี 6 ขั้น Goal ถึง Learn และข้อความ "...-> LEARN -> REPEAT" |
| เห็นโดยตรง | ลูกศร Goal > Context > Plan > Act > Verify > Learn แล้ว Learn > Context |
| เห็นโดยตรง | กล่อง Key idea "From LLMs to Autonomous Agents" พร้อมผลลัพธ์ 4 ข้อ |
| ตีความ | ลูกศรที่ชี้เข้า Goal จากสองด้านคือการปรับเป้าตามบริบทใหม่ |
| ตีความ | เส้นทาง Verify ไม่ผ่านกลับไป Plan ไม่ได้วาดไว้ เราเติมเอง |
| ตีความ | "works while you sleep" เป็นเป้าหมายของระบบ ภาพไม่ได้แสดงหลักฐานว่าทำได้ |
| สมมติ | ตัวอย่างวิธีใช้ ตัวเลข เกณฑ์ผ่าน และคำเตือนในหน้านี้เป็นของเรา ไม่ได้มาจากภาพ |
ลูปของ AI employee
หกขั้นนี้วนซ้ำจนบรรลุเป้าหมายหรือชนเงื่อนไขหยุด
flowchart LR
    G["Goal<br/>ต้องการอะไร"] --> C["Context<br/>รู้อะไรอยู่"]
    C --> P["Plan<br/>จะทำอะไร"]
    P --> A["Act<br/>ใช้ tool"]
    A --> V["Verify<br/>ได้ผลจริงไหม"]
    V --> L["Learn<br/>อัปเดต memory"]
    L --> C
    V -.->|"ไม่ผ่าน (เติมเอง)"| P
| ขั้น | คำถามที่ตอบ | ผลที่ออกมา | ถ้าข้ามขั้นนี้ |
|---|---|---|---|
| Goal | ต้องการอะไร | เป้าหมาย เกณฑ์สำเร็จ ข้อจำกัด | ทำงานไม่รู้ว่าเสร็จเมื่อไร |
| Context | รู้อะไรอยู่แล้ว | ข้อมูลที่เกี่ยวข้องและกรองแล้ว | เดาจากข้อมูลไม่ครบ |
| Plan | ควรทำอะไรต่อ | ขั้นตอนย่อยที่ตรวจดูได้ | ลงมือแบบไร้ทิศ |
| Act | ใช้เครื่องมือเพื่อไปข้างหน้า | ผลกระทบจริงในระบบ | ไม่มีงานเกิดขึ้น |
| Verify | ได้ผลตามที่ตั้งใจไหม | ผ่าน ไม่ผ่าน หรือไม่แน่ใจ | ความผิดพลาดสะสมเงียบ ๆ |
| Learn | ต้องจำอะไรไว้ | รายการใหม่ใน memory | พลาดเรื่องเดิมซ้ำ |
แปดองค์ประกอบ
แต่ละหัวข้อด้านล่างแยกเป็น สิ่งที่ระบุในภาพ, วิธีใช้ (เติมเอง), และข้อผิดพลาดที่พบบ่อย (เติมเอง)
01 Goal: เป้าหมาย
กำหนดวัตถุประสงค์ที่ชัดและมีประโยชน์ต่อโลกจริง เป้าที่ดีต้องเจาะจง วัดได้ และผูกกับคุณค่า
- ระบุผลลัพธ์ที่ต้องการและเกณฑ์สำเร็จ
- แตกเป้าใหญ่เป็นเป้าย่อยที่ทำได้
- กำหนดข้อจำกัด: เวลา งบ เครื่องมือ ขอบเขต
- ปรับเป้าให้ทันเมื่อบริบทเปลี่ยน
วิธีใช้. เขียนเป็นประโยคที่มีตัวเลขและเส้นตาย เช่น "ตอบ ticket หมวด A ภายใน 2 ชั่วโมง ผิดไม่เกิน 3%" และเขียนสิ่งที่ห้ามทำคู่กัน พลาดบ่อย. เป้ากว้างเกิน เช่น "ช่วยดูแลลูกค้า" ทำให้ Verify ไม่มีอะไรเทียบ
02 Context: บริบท
ให้ข้อมูลที่เหมาะกับงาน ทั้งภูมิหลัง สถานะปัจจุบัน ข้อมูลที่เกี่ยวข้อง และความต้องการของผู้ใช้
- รวบรวมเอกสาร ข้อมูล ตัวอย่างที่เกี่ยวข้อง
- ใส่ประวัติการสนทนาล่าสุด
- ระบุรูปแบบ อินเทอร์เฟซ ข้อจำกัด
- กรองสิ่งรบกวนและรักษาบริบทให้โฟกัส
วิธีใช้. ใส่เฉพาะส่วนที่เกี่ยวกับขั้นปัจจุบัน ไม่ใช่ทั้งฐานข้อมูล บริบทยาวขึ้นทำให้แพงขึ้นและตอบพลาดง่ายขึ้น (ตีความ) พลาดบ่อย. ยัดทุกอย่างเข้าไป หรือส่งผลลัพธ์ดิบของ tool ทั้งก้อนกลับเข้ามาทุกรอบ
03 Planning loop: ลูปการวางแผน
แปลงเป้าและบริบทเป็นแผนที่ลงมือทำได้ แตกงานเป็นขั้น ชั่งทางเลือก และปรับแผนเมื่อรู้มากขึ้น
- แตกเป้าเป็นขั้นเล็ก
- พิจารณาหลายแนวทางและข้อแลกเปลี่ยน
- วางแผนใหม่เมื่อมีข้อมูลใหม่
- ทำให้แผนมองเห็นและตรวจดูได้ง่าย
วิธีใช้. ให้ agent เขียนแผนเป็นรายการสั้นที่บันทึกลง log ก่อน Act ทุกรอบ คนย้อนอ่านได้ว่าทำไมถึงทำแบบนั้น พลาดบ่อย. วางแผนละเอียดล่วงหน้าทั้งงาน แล้วไม่ยอมปรับเมื่อผลจริงต่างจากที่คาด
04 Tool use: การใช้เครื่องมือ
ให้ agent เข้าถึงเครื่องมือที่โต้ตอบกับโลกจริง: อ่านข้อมูล รันโค้ด เรียก API และทำสิ่งที่นอกเหนือจากข้อความ
- เชื่อมกับการรันโค้ด ระบบไฟล์ API
- ใช้เครื่องมือสำหรับค้นหา วิเคราะห์ข้อมูล และทำงานอัตโนมัติ
- ให้คำอธิบายและ schema ของเครื่องมือที่ชัดเจน
- ให้ agent เลือกเครื่องมือที่เหมาะกับงาน
วิธีใช้. เริ่มจากสิทธิ์อ่านอย่างเดียว เพิ่มสิทธิ์เขียนทีละอย่าง คำอธิบาย tool ควรมีตัวอย่างการเรียกและกรณีขอบ เอกสารของ Anthropic เน้นว่าการออกแบบ tool ต้องลงแรงเท่ากับการออกแบบหน้าจอสำหรับคน พลาดบ่อย. ให้สิทธิ์กว้างเกินจำเป็น tool หลายตัวที่หน้าที่ซ้อนกัน ทำให้เลือกผิด
05 Memory: ความจำ
ให้ agent มีความจำถาวร เรียนรู้จากประสบการณ์ และรักษาบริบทระยะยาวข้ามเซสชัน
- เก็บข้อเท็จจริง การตัดสินใจ และบทเรียนสำคัญ
- ใช้ความจำแบบมีโครงสร้าง: episodic, semantic, procedural
- ดึงและสรุปได้เร็ว
- ตัดแต่ง บีบอัด และลบรายการซ้ำเมื่อเวลาผ่านไป
| ชนิด | เก็บอะไร | ตัวอย่าง |
|---|---|---|
| Episodic | เหตุการณ์ที่เกิดขึ้น | "ticket 8841 ตอบผิดหมวด แก้โดยคน" |
| Semantic | ข้อเท็จจริง | "คืนเงินได้ภายใน 14 วัน" |
| Procedural | วิธีทำ | "ถ้าลูกค้าขอใบกำกับภาษี ให้เรียก tool ออกเอกสารก่อน" |
คำอธิบายสามชนิดเป็นความรู้ทั่วไป ภาพระบุเฉพาะชื่อ
วิธีใช้. เริ่มจากไฟล์บันทึกบทเรียนหนึ่งไฟล์ที่ agent อ่านตอนเริ่มงาน ใส่วันที่ลงทุกรายการ เพื่อลบรายการเก่าที่ล้าสมัยได้ พลาดบ่อย. เก็บทุกอย่างโดยไม่ตัดแต่ง ความจำที่ผิดจะถูกใช้ซ้ำทุกรอบ อย่าเก็บข้อมูลส่วนบุคคลหรือความลับลงความจำ
06 Verification: การตรวจสอบ
ให้ agent ตรวจงานตัวเองด้วย test กฎตรวจสอบ และ feedback ภายนอก เพื่อเพิ่มความน่าเชื่อถือและจับข้อผิดพลาด
- กำหนดเกณฑ์ตรวจสอบที่ชัดเจน
- ใช้ test อัตโนมัติ linter หรือตัวประเมิน
- ตรวจเทียบข้ามหลายแหล่งหรือหลายเครื่องมือ
- บอกความไม่แน่ใจและกรณีขอบอย่างตรงไปตรงมา
วิธีใช้. เรียงความน่าเชื่อถือของวิธีตรวจจากมากไปน้อย: test ที่รันจริง, กฎที่ตรวจด้วยโค้ด, เทียบกับแหล่งข้อมูลอื่น, ให้โมเดลอีกตัวประเมิน, ให้โมเดลเดิมประเมินตัวเอง (ตีความ) ให้ผลลัพธ์มีค่า "ไม่แน่ใจ" เป็นตัวเลือก แล้วส่งต่อให้คน พลาดบ่อย. ใช้โมเดลตัวเดิมตรวจงานตัวเองแล้วนับว่าผ่าน
07 Feedback: การป้อนกลับ
ปิดลูปด้วยการใช้ feedback เพื่อพัฒนา เรียนรู้จากทั้งความสำเร็จและความล้มเหลว แล้วปรับพฤติกรรม เครื่องมือ และความจำ
- เก็บ feedback จากผลลัพธ์ ผู้ใช้ และเครื่องมือ
- วิเคราะห์ข้อผิดพลาดและหาสาเหตุราก
- อัปเดต memory, prompt และกลยุทธ์
- วัดความก้าวหน้าตามเวลา
วิธีใช้. ทุกครั้งที่คนแก้ผลของ agent ให้บันทึกคู่ "ที่ agent ทำ / ที่คนแก้ / สาเหตุ" แล้วสรุปรายสัปดาห์เป็นกฎใหม่หรือ test ใหม่ พลาดบ่อย. แก้ที่ปลายทางโดยไม่หาสาเหตุราก ทำให้ปัญหาเดิมกลับมา
08 Deployment: การนำไปใช้งานจริง
รัน AI employee ในรูปแบบที่เชื่อถือได้และทำงานต่อเนื่อง ตรวจติดตามงาน รักษาความปลอดภัย และให้ใช้งานได้จริง
- แพ็กเกจพร้อมเครื่องมือและค่าตั้งที่ถูกต้อง
- รันต่อเนื่อง (ตามเวลาหรือเมื่อมีเหตุการณ์)
- ติดตามประสิทธิภาพ ต้นทุน และความปลอดภัย
- เริ่มเล็ก ทำซ้ำ แล้วขยายขอบเขตทีละน้อย
วิธีใช้. เริ่มจากโหมดร่าง ย้ายเป็นอัตโนมัติเฉพาะประเภทงานที่ผลตรวจผ่านต่อเนื่อง ตั้งเพดานต้นทุนต่อวันและสวิตช์หยุดฉุกเฉิน พลาดบ่อย. เปิด 24/7 ตั้งแต่วันแรกโดยไม่มีเพดานต้นทุน ไม่มี log และไม่มีคนรับแจ้งเตือน
ตรวจสอบก่อนปล่อยให้ทำงานจริง
| สถานะ | รายการ | ตรวจอย่างไร |
|---|---|---|
| ⚪ | Goal มีตัวเลขหรือเกณฑ์ที่ตรวจได้ | อ่านแล้วบอกได้ว่าผ่านหรือไม่ผ่านโดยไม่ต้องถามใคร |
| ⚪ | มีเงื่อนไขหยุด (จำนวนรอบ งบ เวลา) | ทดลองสั่งงานที่ทำไม่ได้ ต้องหยุดเอง |
| ⚪ | Verify ใช้หลักฐานภายนอกอย่างน้อย 1 ชนิด | ระบุชนิดหลักฐานของแต่ละงานได้ |
| ⚪ | Tool มีสิทธิ์น้อยที่สุดที่ทำงานได้ | ไล่ดูรายการสิทธิ์ทีละ tool |
| ⚪ | สิ่งที่ย้อนไม่ได้ต้องผ่านคนอนุมัติ | ทดลองสั่งงานลบหรือส่ง ต้องถูกหยุดรอ |
| ⚪ | ทุกรอบถูกบันทึก (แผน การเรียก tool ผลตรวจ) | ย้อนอ่านงานเมื่อวานได้ครบ |
| ⚪ | Memory มีวันที่ และมีวิธีลบรายการผิด | ลองแก้ 1 รายการ |
| ⚪ | มีผู้รับผิดชอบรับแจ้งเตือนและเพดานต้นทุนต่อวัน | ชื่อคนและตัวเลขเขียนไว้แล้ว |
ความเสี่ยงและข้อจำกัด
Warning ส่วนใหญ่ของรายการนี้เป็นความรู้ทั่วไปของเรา ภาพไม่ได้พูดถึงความเสี่ยง เอกสารของ Anthropic ยืนยันเรื่องต้นทุนที่สูงกว่า ความผิดพลาดที่ทบกันได้ และข้อแนะนำให้ทดสอบใน sandbox พร้อม guardrail
| ความเสี่ยง | อาการ | วิธีลด |
|---|---|---|
| ผิดพลาดทบกัน | ขั้นแรกผิดนิดเดียว ขั้นต่อไปสร้างต่อจากของผิด | Verify ทุกขั้น ไม่ใช่เฉพาะตอนจบ |
| วนไม่จบ | ลองซ้ำแบบเดิม ต้นทุนพุ่ง | จำกัดจำนวนรอบ ตรวจจับการทำซ้ำ |
| เป้าหลุด | agent เปลี่ยนความหมายของงานระหว่างทาง | อ้างอิงเป้าเดิมในทุกรอบ ให้คนเห็นแผน |
| ความจำปนเปื้อน | จำข้อเท็จจริงผิดแล้วใช้ซ้ำ | ใส่วันที่ ตรวจรายสัปดาห์ ลบรายการผิด |
| คำสั่งแฝงในข้อมูล | ข้อความจาก tool หรือเว็บสั่งให้ agent ทำสิ่งนอกเป้า | ถือผลจาก tool เป็นข้อมูล ไม่ใช่คำสั่ง จำกัดสิทธิ์ tool |
| ข้อมูลส่วนบุคคลรั่ว | PII ถูกเก็บใน memory หรือ log | กรองก่อนบันทึก จำกัดผู้เข้าถึง log |
| ผู้คนหมดความระวัง | คนกดอนุมัติโดยไม่อ่านเมื่อ agent ถูกบ่อย | สุ่มตรวจเป็นระยะ ตั้งเกณฑ์ที่ต้องมีคนดูเสมอ |
ข้อเท็จจริงเทียบกับความเห็น
| ข้อความ | ประเภท |
|---|---|
| agent ใช้ผลจริงจากสภาพแวดล้อมทุกขั้น (ผล tool, ผลรันโค้ด) ประเมินความคืบหน้า | ข้อเท็จจริง ตามเอกสารของ Anthropic |
| ควรมีเงื่อนไขหยุด และให้หยุดรอคนเมื่อติดขัด | คำแนะนำ ตามเอกสารของ Anthropic |
| agent เหมาะกับปัญหาปลายเปิดที่เดาจำนวนขั้นไม่ได้ | คำแนะนำ ตามเอกสารของ Anthropic |
| การรันตลอด 24/7 เพิ่มผลผลิตของทีม | ความเห็น ยังไม่มีหลักฐานในภาพ |
| ลูปที่ครบ 6 ขั้นน่าเชื่อถือกว่า LLM ตัวเดียว | ความเห็น สมเหตุสมผลแต่ยังไม่ทดสอบ |
| ตัวอย่าง 88.75% ในหน้านี้ | สมมติ คำนวณจากตัวเลขที่เราตั้ง |
Sources
| สถาบัน | เอกสาร | ใช้กับส่วนไหน |
|---|---|---|
| Anthropic | Building effective agents (anthropic.com/engineering/building-effective-agents) | นิยาม agent กับ workflow, เงื่อนไขหยุด, การออกแบบ tool, ต้นทุน, sandbox |
ตัวย่อที่ใช้ในหน้านี้
| ตัวย่อ | ชื่อเต็ม | คืออะไร | อ่านค่าอย่างไร |
|---|---|---|---|
| AI | Artificial Intelligence | ระบบคอมพิวเตอร์ที่ทำงานที่ปกติต้องใช้ความฉลาดของคน | "AI employee" = agent ที่ทำงานแทนพนักงานในขอบเขตที่กำหนด |
| LLM | Large Language Model | โมเดลภาษาขนาดใหญ่ที่สร้างข้อความจากข้อความ | ในหน้านี้ใช้เป็น "สมอง" ที่อยู่ตรงกลางของลูป |
| API | Application Programming Interface | ช่องทางให้โปรแกรมหนึ่งเรียกใช้อีกโปรแกรมด้วยคำสั่งที่กำหนดไว้ | "เรียก API ของระบบ ticket" = สั่งระบบนั้นอ่านหรือเขียนข้อมูลผ่านโค้ด |
| PII | Personally Identifiable Information | ข้อมูลที่ระบุตัวบุคคลได้ เช่น ชื่อ เบอร์โทร อีเมล | "กรอง PII ก่อนบันทึก" = ลบหรือปิดบังข้อมูลเหล่านี้ก่อนเขียนลง log |
| 24/7 | 24 ชั่วโมง 7 วัน | ทำงานต่อเนื่องไม่หยุด | "เปิด 24/7" = รันทุกวันทั้งวันโดยไม่ต้องมีคนเริ่มงาน |
ความหมายของ AI, LLM, API, PII มาจากความรู้ทั่วไป ภาพไม่ได้ให้นิยามไว้ ภาพให้เฉพาะคำว่า "24/7" ในชื่อเรื่อง และ "LLMs" ในกล่อง Key idea
Summary
| หัวข้อ | สรุป |
|---|---|
| แกนของเรื่อง | ลูป 6 ขั้น Goal ถึง Learn วนซ้ำด้วยเครื่องมือและความจำ |
| ส่วนที่สำคัญที่สุด | เป้าหมายที่วัดได้ เงื่อนไขหยุด และ Verify ที่ใช้หลักฐานภายนอก |
| หลักฐานเชิงปริมาณ | ไม่มีในภาพ ผลดีทุกข้อเป็นการตีความหรือยังไม่ทดสอบ |
| ข้อควรระวัง | ต้นทุนสูงขึ้นและความผิดพลาดทบกันได้ ต้องมีจุดอนุมัติสำหรับสิ่งที่ย้อนไม่ได้ |
| ก้าวแรก | งานซ้ำ 1 อย่าง รันโหมดร่าง 1 สัปดาห์ วัดเทียบ baseline |