แก่นของเรื่อง
แนวคิดหลัก. ใน coding agent มีสถานีเดียวที่เขียนโค้ดจริง อีกห้าจุดเป็นการตัดสินใจที่ตอบได้ด้วยตัวเลือกจำนวนน้อย: อ่านไฟล์ไหน ส่งงานให้โมเดลระดับไหน คำสั่งนี้รันได้ไหม งานเสร็จหรือยัง และผลลัพธ์ของ tool ตัวไหนควรเก็บไว้ ถ้าให้โมเดลใหญ่ตัวเดียวตอบทั้งหมดในบริบทยาว ก็จ่ายราคาแพงเพื่อเลือกข้อหนึ่งจากสี่ข้อ
ทำไมถึงได้ผล. ต้นทุนของการเรียกโมเดลคือขนาดบริบทที่ต้องอ่านซ้ำคูณราคาต่อโทเคน การตัดสินใจที่ตัดสถานะให้เล็กลงก่อน (เฉพาะส่วนที่เกี่ยวกับคำถามนั้น) แล้วส่งให้โมเดลเล็กจึงถูกลงทั้งสองตัวคูณ นอกจากนี้ชนิดของคำตอบถูกกำหนดไว้ล่วงหน้า (ให้คะแนน เลือก 1 ใน N หรือตอบแบบใช่/ไม่ใช่) ระบบจึงไม่ต้องแกะคำตอบจากร้อยแก้วกลับมาเป็นค่าที่ใช้ต่อได้
20% ที่สำคัญที่สุดในทางปฏิบัติ (ตีความ ไม่ได้ระบุในภาพ):
| ลำดับ | จุด | เหตุผล |
|---|---|---|
| ทำก่อน | "รันได้ไหม" (ลบไฟล์, ใช้เครือข่าย, เขียนประวัติ git ใหม่) | พลาดแล้วย้อนไม่ได้ ภาพไฮไลต์ประโยคเกี่ยวกับจุดนี้ไว้ด้วย |
| ทำต่อ | "ใช้โมเดลระดับไหน" | ลดต้นทุนทุกขั้นที่ตามมา |
| รอได้ | "เก็บหรือทิ้ง" ผลลัพธ์ของ tool | สำคัญเมื่อรันนานเท่านั้น |
ช่วยให้ดีขึ้นอย่างไร
| สถานการณ์ | ไม่ใช้วิธีนี้ | ใช้วิธีนี้ | วัดอย่างไร | หลักฐาน |
|---|---|---|---|---|
| ต้นทุนต่อการตัดสินใจ 1 ครั้ง | $0.130 (โมเดลใหญ่, cache ติด) | $0.0001 | ดอลลาร์ต่อครั้ง ตามตารางราคาในภาพ ค่าหลังปัดเศษ | วัดแล้ว (ตัวเลขจากภาพ ยังไม่ยืนยันกับผู้ให้บริการ) |
| ต้นทุนต่อเดือน | $1,716 | $1 | ดอลลาร์ต่อเดือน | วัดแล้ว (ตัวเลขจากภาพ) |
| ต้นทุนต่อเดือน เมื่อโมเดลใหญ่ cache พลาด (prefix เปลี่ยน) | $15,972 | $1 | ดอลลาร์ต่อเดือน | วัดแล้ว (ตัวเลขจากภาพ) |
| ความถูกต้องของคำตอบ | โมเดลใหญ่ตอบ | โมเดลเล็กตอบ | อัตราตรงกันของคำตอบกับโมเดลใหญ่ | ยังไม่ทดสอบ (ภาพไม่มีตัวเลขความแม่นยำ) |
| โอกาสรันคำสั่งทำลายข้อมูลโดยไม่มีคนเห็น | ขึ้นกับว่าโมเดลเขียนคำเตือนไว้หรือไม่ | มีจุดตรวจเฉพาะ ถ้าย้อนไม่ได้ต้องรอคนอนุมัติ | จำนวนคำสั่งทำลายที่ผ่านโดยไม่ผ่านจุดตรวจ | ตีความ |
| เวลารอต่อการตัดสินใจ | ไม่ระบุ | ไม่ระบุ | วินาทีต่อครั้ง | ยังไม่ทดสอบ |
ข้อสังเกต: ตัวเลขที่วัดได้ในภาพมีแต่ต้นทุน ไม่มีตัวเลขที่บอกว่าคุณภาพของการตัดสินใจเท่าเดิม ตัวเลข $1 ต่อเดือนจึงบอกได้แค่ว่า "ถ้าคำตอบใช้ได้ ราคาเป็นเท่านี้"
ลองใช้
คำนวณซ้ำตารางต้นทุน
ราคาในภาพ (ต่อล้านโทเคน): โมเดลใหญ่ input $10, cached input $1, output $50 ส่วน Jev input $0.042 ภาพระบุบริบท 120,000 โทเคนต่อการเรียกโมเดลใหญ่ ส่วน output ประมาณ 200 โทเคน ภาพไม่ได้ระบุไว้ ตัวเลขนี้คำนวณย้อนจากตาราง (ตีความ)
| ขั้นคำนวณ | cache ติด | cache พลาด |
|---|---|---|
| อ่านบริบท 120,000 โทเคน | 120,000 x $1 / 1,000,000 = $0.12 | 120,000 x $10 / 1,000,000 = $1.20 |
| output 200 โทเคน | 200 x $50 / 1,000,000 = $0.01 | $0.01 |
| ต่อการตัดสินใจ 1 ครั้ง | $0.13 | $1.21 |
| x 15 ครั้งต่อเซสชัน | $1.95 | $18.15 |
| x 880 เซสชันต่อเดือน | $1,716 | $15,972 |
ตัวเลข 15 ครั้งและ 880 เซสชัน ภาพไม่ได้ระบุ แต่เป็นค่าที่ทำให้ทั้งสองคอลัมน์ในตารางของภาพตรงกันพอดี จึงใช้เป็นสมมติฐานของการคำนวณ (ตีความ)
ตัวอย่างโครงสร้างคำถาม (ถอดจากภาพ)
r = client.system_one(state=step, questions={
    "tier": Choice(
        instructions="Which model should do this step?",
        criteria={
            "cheap":    "Mechanical edit, local, low risk.",
            "mid":      "Bounded change across a few files.",
            "frontier": "Design change or unknown code.",
            "ask":      "Brief unclear; a person decides.",
        },
    ),
    "destructive": Noul(
        instructions="Does this delete or overwrite data?"),
})
อ่านโครงสร้าง: ส่ง state ของขั้นปัจจุบันพร้อมชุดคำถามที่ตั้งชื่อไว้ แต่ละคำถามมีชนิดคำตอบกำกับ ชื่อ system_one และคลาสเหล่านี้เป็นตามที่ปรากฏในภาพ ยังไม่ได้ตรวจว่ามีไลบรารีจริงหรือไม่
เมื่อไรควรและไม่ควรใช้
| เงื่อนไข | ใช้ | ไม่ใช้ |
|---|---|---|
| ปริมาณการตัดสินใจ | หลายสิบครั้งต่อเซสชันและหลายร้อยเซสชันต่อเดือน | ใช้ agent สัปดาห์ละไม่กี่ครั้ง ต้นทุนเดิมยังต่ำ |
| ชนิดคำถาม | ตัวเลือกแน่นอน ตอบจากสถานะที่ตัดมาได้ | ต้องเข้าใจทั้ง codebase จึงจะตอบได้ |
| ความเสียหายเมื่อพลาด | มีจุดย้อนกลับหรือมีคนอนุมัติท้ายทาง | ไม่มีใครตรวจ และผลเสียแรง |
| ข้อกำหนดก่อนเริ่ม | log การตัดสินใจเดิมของ agent ให้เทียบคำตอบได้ | ไม่มี log และไม่มีทางวัดความถูกต้อง |
ก้าวแรกที่เล็กที่สุดและวิธีตรวจว่าได้ผล
- เลือกคำถามเดียว คือ "คำสั่งนี้ลบหรือเขียนทับข้อมูลหรือไม่"
- ดึงคำสั่งจริง 50 คำสั่งจาก log ของ agent ให้โมเดลใหญ่และโมเดลเล็กตอบคนละรอบ
- วัดอัตราที่โมเดลเล็กตอบตรงกับโมเดลใหญ่ และจำนวนกรณี "ทำลายจริงแต่โมเดลเล็กตอบว่าไม่"
- เกณฑ์ผ่านที่ตั้งก่อนรัน (ค่าที่เราเลือกเอง ไม่ได้มาจากภาพ): ตรงกันอย่างน้อย 95% และกรณีพลาดฝั่งอันตรายเป็น 0 จาก 50
ทดสอบความเข้าใจ
| คำถาม | คำตอบ | คำตอบที่มักผิด |
|---|---|---|
| ทำไมคำตอบแบบมีชนิด (Score, Choice, Noul) ถึงลดต้นทุนได้นอกจากราคาต่อโทเคน | ไม่ต้องแกะร้อยแก้วกลับเป็นค่า และคำตอบสั้น จ่าย output น้อยลง | "เพราะโมเดลเล็กฉลาดพอ" (ภาพไม่ได้พิสูจน์เรื่องนี้) |
| แก้ cache ($1.21 เป็น $0.13) หรือใช้โมเดลถูก ($0.0017) อย่างไหนลดมากกว่า | โมเดลถูก: 0.13 / 0.0017 ราว 76 เท่า ส่วน cache: 1.21 / 0.13 ราว 9.3 เท่า | "แก้ cache ให้ติดก็พอ" (ลดได้แค่ราว 9 เท่า และยังเป็นโมเดลใหญ่อยู่) |
| ตัวเลข $1 ต่อเดือนพิสูจน์ว่าวิธีนี้ดีกว่าหรือไม่ | ไม่ พิสูจน์แค่ต้นทุน ยังต้องวัดว่าคำตอบถูกพอกัน | "พิสูจน์แล้ว ถูกกว่า 1,700 เท่า" |
| จาก 5 จุด จุดไหนมีทางออกไปหาคนแทนที่จะวนลูปต่อ | รันได้ไหม (ถ้าย้อนไม่ได้ รอคนอนุมัติ) กับ เสร็จหรือยัง (หยุดถามคน) | "ทุกจุด" |
| "เสร็จหรือยัง" ควรตัดสินจากอะไร | ผลทดสอบสดครั้งล่าสุด ไม่ใช่สรุปของ agent เอง | "สรุปที่ agent เขียนเองว่าทำเสร็จแล้ว" |
| ทำไมจุด "เก็บหรือทิ้ง" ให้คะแนนผลลัพธ์ tool แต่ละชิ้นแทนการสรุปทั้งก้อน | ชิ้นที่รอดถูกเก็บคำต่อคำ การสรุปเป็นย่อหน้าเดียวทำให้รายละเอียดหาย | "เพราะสรุปแพงกว่า" |
ภาพอ้างอิงและสิ่งที่อ่านได้จากภาพ
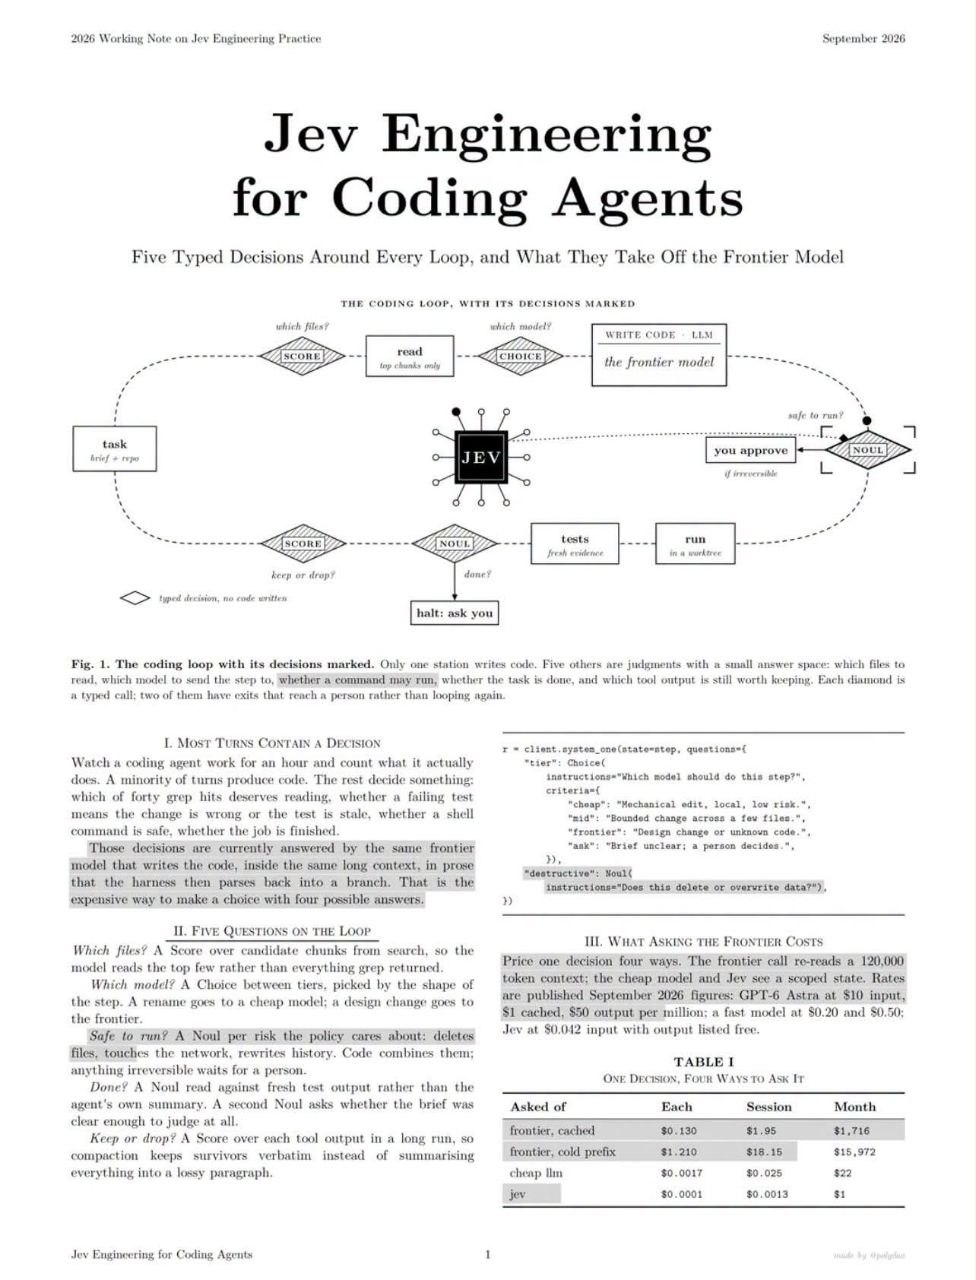
ภาพเป็นหน้าเอกสารเดียว มีแผนภาพวงจร (Fig. 1) ย่อหน้าสามส่วน บล็อกโค้ด และตารางต้นทุน ประโยคบางส่วนในภาพถูกไฮไลต์ ได้แก่ ประโยคเรื่องคำถามที่ตอบด้วยโมเดลใหญ่ตัวเดียวกัน ประโยคเรื่องคำสั่งที่รันได้ ประโยคเรื่องการลบไฟล์/ใช้เครือข่าย/เขียนประวัติใหม่ ย่อหน้าราคา และแถว frontier cached, frontier cold prefix กับ jev ในตาราง
ลูปตามแผนภาพ (ทิศทางลูกศรเป็นการตีความ)
flowchart LR
    T["task: brief + repo"] --> S1{{"Score: which files?"}}
    S1 --> R["read: top chunks only"]
    R --> C{{"Choice: which model?"}}
    C --> W["write code: frontier model"]
    W --> N1{{"Noul: safe to run?"}}
    N1 -->|irreversible| A["you approve"]
    A --> RUN
    N1 -->|safe| RUN["run in a worktree"]
    RUN --> TEST["tests: fresh evidence"]
    TEST --> N2{{"Noul: done?"}}
    N2 -->|done or unclear| H["halt: ask you"]
    N2 -->|continue| S2{{"Score: keep or drop?"}}
    S2 --> T
5 จุดตัดสินใจ
| จุด | ชนิดคำตอบ | ตัดสินอะไร | แหล่งข้อมูลที่ใช้ตัดสิน |
|---|---|---|---|
| อ่านไฟล์ไหน | Score | ให้คะแนนชิ้นส่วนไฟล์ที่ค้นเจอ อ่านเฉพาะบนสุด | ผลค้น (grep) |
| ใช้โมเดลระดับไหน | Choice | เลือกระดับตามลักษณะของขั้น เช่น เปลี่ยนชื่อไปโมเดลถูก งานออกแบบไปโมเดลใหญ่ | ขั้นปัจจุบัน |
| รันได้ไหม | Noul (หนึ่งข้อต่อความเสี่ยงที่นโยบายสนใจ) | ลบไฟล์ แตะเครือข่าย เขียนประวัติใหม่ ถ้าย้อนไม่ได้ รอคน | คำสั่งที่จะรัน |
| เสร็จหรือยัง | Noul (อีกข้อถามว่า brief ชัดพอจะตัดสินหรือไม่) | อ่านเทียบกับผลทดสอบสด | ผลทดสอบล่าสุด |
| เก็บหรือทิ้ง | Score | ให้คะแนนผลลัพธ์ tool แต่ละชิ้นในการรันยาว เก็บที่รอดคำต่อคำ | ผลลัพธ์ tool |
ข้อเท็จจริงที่อ่านได้ชัดเจนกับสิ่งที่ไม่ชัด
| ประเด็น | สถานะ |
|---|---|
| ข้อความทั้งหมดในหน้า ตารางต้นทุน และบล็อกโค้ด | อ่านได้ครบ |
| ความหมายของคำว่า Noul | ภาพไม่นิยามไว้ ใช้กับคำถามใช่/ไม่ใช่ จึงตีความว่าเป็นชนิดคำตอบแบบนั้น |
| โหนดกลางชื่อ Jev ที่มีเส้นล้อมรอบ | ภาพไม่อธิบายหน้าที่ รู้แค่ว่าเป็นชื่อระบบที่ถามคำถามเหล่านี้ |
| ราคา "GPT-6 Astra" และการเปรียบเทียบที่อ้างว่าประกาศเดือนกันยายน 2026 | ยังไม่ยืนยันกับผู้ให้บริการในรอบนี้ |
| ที่มาของ 15 ครั้งต่อเซสชัน และ 880 เซสชันต่อเดือน | ไม่มีในภาพ คำนวณย้อนจากตาราง |
| ความแม่นยำของโมเดลเล็กเมื่อเทียบกับโมเดลใหญ่ | ไม่มีในภาพ |
ความเสี่ยงและข้อจำกัด
Warning ตารางต้นทุนไม่มีตัวเลขคุณภาพ การเอาตัวเลข $1 ต่อเดือนไปตั้งเป็นเป้าโดยไม่วัดอัตราตรงกันของคำตอบ ทำให้ได้ระบบที่ถูกแต่ตัดสินผิดโดยไม่มีใครเห็น
| ความเสี่ยง | เกิดเมื่อ | ลดอย่างไร |
|---|---|---|
| โมเดลเล็กตอบ "ปลอดภัย" ทั้งที่คำสั่งทำลายข้อมูล | ตัดสถานะจนไม่เหลือบริบทที่จำเป็นต่อคำถาม | วัดกรณีพลาดฝั่งอันตราย ให้เป็น 0 ก่อนเปิดใช้ และให้คนอนุมัติเมื่อย้อนไม่ได้ |
| ได้คำตอบผิดชนิด | ไม่ตรวจชนิดของคำตอบก่อนใช้ | ปฏิเสธคำตอบนอกชุดที่กำหนดแล้วส่งขึ้นระดับบน |
| ต้นทุนพุ่งเพราะ cache พลาด | prefix เปลี่ยนทุกเทิร์น | ดูหน้าเรื่อง cache ของโมเดลสามระดับ |
| ตัดสินว่าเสร็จจากคำพูดของ agent | อ่านสรุปแทนผลทดสอบ | บังคับให้ตัดสินจากผลทดสอบสดเท่านั้น |
Decision / next steps
Recommendation เริ่มที่จุดเดียวคือ "รันได้ไหม" ทดลองกับคำสั่ง 50 รายการจาก log จริง ตั้งเกณฑ์ผ่านก่อนรัน และขยายไปจุด "ใช้โมเดลระดับไหน" ต่อเมื่อผ่านเกณฑ์
ตัวย่อที่ใช้ในหน้านี้
| ตัวย่อ | ชื่อเต็ม | คืออะไร | อ่านค่าอย่างไร |
|---|---|---|---|
| LLM | Large Language Model | โมเดลภาษาขนาดใหญ่ (ในภาพใช้คำว่า cheap llm หมายถึงโมเดลราคาถูก) | "cheap llm $0.0017" = ต้นทุนต่อการตัดสินใจ 1 ครั้งของโมเดลถูก คือ 0.0017 ดอลลาร์ |
| GPT | Generative Pre-trained Transformer | ชื่อตระกูลโมเดลภาษา ในภาพเป็นชื่อรุ่นของโมเดลใหญ่ในตารางราคา | "GPT-6 Astra" = ชื่อรุ่นที่ภาพอ้าง ยังไม่ยืนยัน |
| API | Application Programming Interface | ช่องทางให้โปรแกรมเรียกบริการอื่น | client.system_one(...) = ตัวอย่างการเรียกผ่าน API ตามภาพ |
| x | เท่า (ตัวคูณ) | ใช้คูณในตารางคำนวณ | "15 ครั้ง x $0.13" = 15 คูณ 0.13 |
แถว GPT และ API เป็นความรู้ทั่วไป ภาพไม่ได้นิยามไว้
ศัพท์เฉพาะ
| คำ | ความหมาย |
|---|---|
| frontier model | โมเดลระดับสูงสุดที่มี ราคาแพงที่สุด |
| cached / cold prefix | cached = ส่วนต้นบริบทที่ใช้ซ้ำ อ่านราคาถูก, cold = ไม่ติด cache จ่ายเต็ม |
| worktree | สำเนาทำงานแยกของ git สำหรับรันโดยไม่แตะงานหลัก |
| Noul | ชนิดคำตอบสำหรับคำถามแบบใช่/ไม่ใช่ ภาพไม่นิยามไว้ (ตีความ) |
Summary
- เทิร์นส่วนใหญ่ของ coding agent เป็นการตัดสินใจ มีสถานีเดียวที่เขียนโค้ด
- 5 จุดตัดสินใจ: อ่านไฟล์ไหน, โมเดลระดับไหน, รันได้ไหม, เสร็จหรือยัง, เก็บหรือทิ้ง
- ตัวเลขในภาพ: $0.130 เหลือ $0.0001 ต่อครั้ง และ $1,716 เหลือ $1 ต่อเดือน (ยังไม่ยืนยันกับผู้ให้บริการ และไม่มีตัวเลขคุณภาพ)
- เริ่มที่จุด "รันได้ไหม" วัดกับ 50 คำสั่งจริง ตั้งเกณฑ์ผ่านก่อนรัน
| ตัวเลขสำคัญ | ค่า |
|---|---|
| ต้นทุนต่อครั้ง โมเดลใหญ่ cache ติด | $0.13 |
| ต้นทุนต่อครั้ง Jev | $0.0001 |
| ต้นทุนต่อเดือน โมเดลใหญ่ cache พลาด | $15,972 |
| ต้นทุนต่อเดือน Jev | $1 |