แก่นของเรื่อง
ถ้าจำได้อย่างเดียว ให้จำประโยคนี้ (สรุปของเรา จากข้อเท็จจริงในหน้านี้): ผล backtest เชื่อได้เท่ากับกฎที่ล็อกไว้ก่อนเห็นผล ถ้ากฎ execution, ต้นทุน และบทบาทของแต่ละ window ไม่ถูกล็อก ผู้ชนะที่เลือกได้อาจเป็นผลของการลองหลายครั้ง ไม่ใช่ความสามารถของกลยุทธ์
ทำไมถึงได้ผล
- การเลือก config ที่ดีที่สุดจากหลายชุดบนข้อมูลชุดเดียว ทำให้ผู้ชนะมีโชคปนอยู่ ยิ่งลองมากยิ่งพอง (เหตุผลเดียวกับที่ PBO และ DSR ถูกสร้างมาวัด) (p.53-54)
- ต้นทุนของ perpetual futures เกิดตาม turnover และตามเวลาที่ถือ position ถ้าไม่ใส่ จะพองไม่เท่ากันทุก config ลำดับผู้ชนะจึงเปลี่ยนได้ (p.57 ระบุว่าลำดับ candidate เปลี่ยนได้ แต่ไม่มีตารางแสดง)
- ถ้า window ที่ใช้เลือกถูกเรียกว่า out-of-sample ตัวเลขที่รายงานก็ไม่เป็นอิสระจากการเลือก (p.52)
- การล็อกกฎล่วงหน้าไม่ได้ทำให้กลยุทธ์ดีขึ้น มันทำให้ตัวเลขที่ออกมาตรงกับสิ่งที่จะเกิดขึ้นจริงมากขึ้น แล้วจึงรู้ว่ากลยุทธ์ดีหรือไม่
20% ที่สำคัญที่สุดในการใช้งานจริง
| ลำดับ | ทำอะไร | ทำไมทำก่อน |
|---|---|---|
| 1 | ใส่ fee, slippage, funding และ cap ให้ครบใน backtest เดียว | ทำง่าย และเปลี่ยน CAGR ได้ 37-48% (คำนวณจาก p.45) |
| 2 | ใช้ t+1 และ funding carry-forward เป็นกฎของ engine | กันข้อผิดพลาดเชิงโครงสร้าง (p.19) |
| 3 | เขียนก่อนรันว่า window ไหนใช้เลือก window ไหนไม่แตะ | ป้องกันการเรียกผล validation ว่า out-of-sample (p.30) |
| 4 | ส่งออกผลรายแท่ง (ledger) ที่แยกต้นทุนแต่ละช่อง | ตรวจย้อนได้ทุกตัวเลข (p.60) |
| 5 | เขียน threshold ของการคัดเลือกก่อนเห็นผล | กันการปรับเกณฑ์ตามผล (p.30) |
ยังไม่ต้องทำในรอบแรก: Bayesian optimizer (random หรือ grid ก็ใช้ pipeline เดียวกันได้ p.15), Live guard, DSR และ PBO ส่วนนี้เพิ่มเมื่อ pipeline สร้างผลซ้ำได้แล้ว (ข้อเสนอของเรา)
ช่วยให้ดีขึ้นอย่างไร
แต่ละแถวบอกว่าอะไรดีขึ้น เท่าไร และหลักฐานระดับไหน
| สถานการณ์ | ถ้าไม่ทำ | ถ้าทำ | ป้าย |
|---|---|---|---|
| เห็นผลตอบแทนเกินจริง | CAGR 4.308 (แค่ fee) | CAGR 2.726 (ต้นทุนครบ) ต่ำลง 36.7% | วัดแล้ว (p.45) |
| เลือกจาก window เดียว | Baseline +16.6% บน training | -56.4% บน validation, MaxDD 0.92 | วัดแล้ว (p.39) |
| เลือก config เสี่ยงต่ำลง | MaxDD 0.318 (one-stage, validation BTC) | MaxDD 0.231 (two-stage) | วัดแล้ว (p.41) |
| ผลตอบแทนหลังกรองสองขั้น | monthly 0.051 (validation) | monthly 0.038 ผลต่างแยกจากศูนย์ไม่ได้ | วัดแล้ว ผลผสม (p.43) |
| กัน look-ahead ด้วย t+1 | t+0: CAGR -0.264 | t+1: -0.221 t+0 ไม่ได้พองผลในช่วงนี้ | วัดแล้ว ไม่พบผลพอง (p.61) |
| Reconcile backtest กับ replay | ผลต่างที่มองไม่เห็น | ผลต่าง signal และ exposure = 0 (2 สินทรัพย์) | วัดแล้ว ระดับการตรวจระบบ (p.23) |
| ลด exposure ตาม drawdown | CAGR -24.09% | +0.37% ถึง +8.46% | วัดแล้ว ไม่มี hold-out แยก (p.49) |
| Live guard | ไม่มีตัวหยุดอัตโนมัติ | หยุดเมื่อ performance ผิดปกติ | ยังไม่ทดสอบ (p.24) |
| ตรวจว่าผู้ชนะเป็นโชคหรือไม่ | ไม่รู้ | PBO 0.586 บอกว่ายังมีความเสี่ยงสูง | วัดแล้ว บอกปัญหา ไม่ได้แก้ (p.25) |
อ่านแล้วได้ข้อสรุปสามข้อ
- ได้ผลชัดที่สุด: ต้นทุนครบทำให้ผลที่เห็นลดลงเกินหนึ่งในสาม เป็นขั้นที่ควรทำก่อนอย่างอื่น
- ได้ผลด้านความเสี่ยง ไม่ใช่ผลตอบแทน: Stage II ลด drawdown ใน 10 จาก 12 window แต่ไม่ได้เพิ่มกำไร
- ยังพิสูจน์ไม่ได้: ว่าผลที่ผ่านทุกด่านจะทำกำไรจริง PBO ยังสูง และ blind hold-out ของ BTC ที่ buy-and-hold ชนะ
ลองใช้
ตัวอย่างประกอบ: ต้นทุนกินผลไปเท่าไร
ตัวเลขนี้เป็นเลขคณิตจากค่าที่รายงาน ไม่ใช่ผลทดลองของ pipeline
| รายการ | วิธีคิด | ผลลัพธ์ |
|---|---|---|
| Funding แบบ fallback | 1 bp ต่อ 8 ชั่วโมง x 3 รอบต่อวัน x 365 | 10.95% ต่อปี ต่อ notional 1 เท่า |
| ถ้าถือ 5 เท่า (leverage สูงสุด) | 10.95% x 5 | 54.75% ต่อปีของทุน ถ้าถือเต็มตลอด |
| Fee + slippage ต่อการเปลี่ยน position 1 หน่วย | (4 + 2) bps | 0.06% ของ notional |
| 636 เทรด ขนาดเปลี่ยนครั้งละ 1 หน่วย | 636 x 0.06% | 38.2% ของ notional ตลอดช่วง |
| ต่อปี (ช่วง core ยาว 5,069 / 2,190 = 2.31 ปี) | 38.2% / 2.31 | ราว 16.5% ต่อปี |
ค่าที่ใช้มาจาก p.34 (fee 4 bps, slippage 2 bps, funding fallback 1 bp ต่อ 8 ชั่วโมง) และ p.45 (636 trades) สมมติฐาน [ASSUMPTION]: ขนาดการเปลี่ยน position ต่อครั้งเป็น 1 หน่วย ซึ่งในงานจริงต่างกันตาม exposure ที่ถูกลดหรือสมูท และ funding จริงเปลี่ยนตามตลาด (fallback เป็นค่าคงที่แบบระวังไว้ก่อน) ใช้ตัวเลขนี้เพื่อให้เห็นลำดับขนาดเท่านั้น ไม่ใช่การประเมินต้นทุนจริงของ config นั้น
ข้อสังเกต: ในสมมติฐานนี้ funding ที่ถือเต็ม 1 เท่าตลอด (ราว 11% ต่อปี) กับ fee รวม slippage (ราว 16.5% ต่อปี) มีขนาดใกล้กัน ถ้าตัดช่องใดช่องหนึ่งออกจะมองผลดีเกินจริง
ใช้เมื่อไหร่
| หัวข้อ | รายละเอียด |
|---|---|
| ใช้เมื่อ | มีกลยุทธ์บน perpetual futures ที่สัญญาณกำหนดแล้ว และอยากเลือกพารามิเตอร์ |
| ใช้เมื่อ | เทรดถี่พอที่ต้นทุนมีนัยสำคัญ (ในงานนี้หลายร้อยถึงหลายพันเทรด) |
| ไม่ควรใช้เป็นเหตุผลเมื่อ | ต้องการหาสัญญาณใหม่ งานนี้ไม่สร้างสัญญาณ (p.1) |
| ไม่พอเมื่อ | ทุนใหญ่ถึงระดับที่มี market impact (p.56) |
| ไม่พอเมื่อ | เทรดความถี่สูงมาก งานนี้ทดสอบแค่แท่ง 4 ชั่วโมง (p.62) |
| ต้องมีก่อน | ข้อมูล OHLCV ต่อเนื่อง ชุด funding ตามเวลาจริง และโปรไฟล์ต้นทุนที่จริง |
ก้าวแรกที่เล็กที่สุด
รัน backtest ของ config ที่มีอยู่ 3 รอบด้วยสัญญาณและ engine เดียวกัน: ไม่มีต้นทุน, เฉพาะ fee, ต้นทุนครบ แล้วดูว่าตัวเลขลดลงเท่าไร
วิธียืนยันว่าดีขึ้นจริง (ข้อเสนอของเรา)
| รายการ | วิธีวัด | เกณฑ์ที่ต้องตั้งก่อนรัน |
|---|---|---|
| Cost ladder | CAGR ของสามระดับ ของ config เดียวกัน | ช่องว่างสูงสุดที่ยอมรับ |
| Window | ผลของ window ที่ไม่เคยใช้เลือก | ต้องไม่ตกจาก training เกินเท่าที่กำหนด |
| ผู้ชนะ | ผลของผู้ชนะเมื่อ threshold เปลี่ยนเล็กน้อย | ผู้ชนะต้องไม่สลับทุกครั้ง |
| ความสอดคล้อง | ผลต่าง signal และ exposure ของ backtest กับ replay | เท่ากับศูนย์ภายใน tolerance |
ทดสอบความเข้าใจ
| คำถาม | คำตอบ | คำตอบที่มักผิด |
|---|---|---|
| Validation ไม่ถูกใช้ใน Stage I ผลบน validation เรียกว่า out-of-sample ได้ไหม | ไม่ได้ เพราะ Stage II ใช้มันเลือก candidate เหลือแค่ blind hold-out (p.30) | "ได้ เพราะ Stage I ไม่เห็น" |
| Two-stage ให้ผลตอบแทนต่ำกว่า one-stage ใน 10 จาก 12 window แปลว่ามันแย่กว่าไหม | ไม่ใช่เป้าหมาย มันวัดความเปราะบาง และ CI ของผลต่างบน BTC คร่อมศูนย์ สรุปไม่ได้ | "ต่ำกว่าแปลว่าไม่ควรใช้" |
| จาก 4.308 เป็น 2.726 สรุปได้ไหมว่า funding อย่างเดียวทำให้ลดไป 36.7% | ไม่ได้ ตารางรวม slippage และ funding ไว้ขั้นเดียว ต้องรันแยกถึงจะรู้สัดส่วน | "ทั้งหมดเป็นผลของ funding" |
| เพดาน DD 0.25 ให้ผู้ชนะ MaxDD บน validation 0.386 แต่เพดาน 0.30 ให้ 0.231 ทำไม | ตัวกรองวัดเฉลี่ยข้ามสถานการณ์บน training+validation ไม่ใช่ validation เดียว | "ระบบมีบั๊ก" |
| t+0 ให้ผลแย่กว่า t+1 ใน snapshot นี้ แปลว่า t+0 ใช้ได้ไหม | ไม่ได้ t+0 ใช้ข้อมูลที่ยังไม่มีตอนตัดสินใจ กฎยึดหลักการ ไม่ใช่ผล sample เดียว | "ผลไม่พอง ก็ไม่ต้องกัน" |
| ลด exposure ตาม drawdown ทำให้ CAGR จาก -24.09% เป็น +8.46% นำไปใช้ได้เลยไหม | ยัง รายงานบน window ยาวเดียวไม่มี hold-out แยก และ MaxDD ยังสูง 0.695 (p.49) | "ได้ผลชัด ใช้เลย" |
Core concepts
ต้นทุนและ execution ของ perpetual futures ต่างจากตลาดหุ้น จึงต้องรู้ก่อนว่า backtest พองได้จากช่องไหนบ้าง
แหล่งที่ทำให้ backtest พอง
| ช่อง | กลไก | ผลถ้ามองข้าม |
|---|---|---|
| Look-ahead ของราคา | ใช้แท่งหลัง timestamp ปัจจุบัน | ผลดีเกินจริง (p.2) |
| Look-ahead ของ funding | ใช้ funding ที่ยังไม่ประกาศ หรือเติมย้อนหลัง | ต้นทุนถูกประเมินผิด (p.19) |
| ต้นทุนไม่ครบ | ไม่ใส่ fee สองขา, funding, slippage, cap | ผลพอง (p.2) |
| ใช้ window ซ้ำ | window ที่เลือกพารามิเตอร์ถูกเรียกว่า out-of-sample | ผลทดสอบไม่เป็นอิสระ (p.52) |
| ลองหลายชุด | เลือกผู้ชนะจากหลาย config และหลาย window | ผู้ชนะอาจเป็นโชค (p.53-54) |
STRICT4H: กฎ execution ที่ล็อกไว้
- t+1: สัญญาณคำนวณที่ปิดแท่ง t มีผลตั้งแต่แท่ง t+1 เท่านั้น ห้าม execute ในแท่งเดียวกัน (p.19)
- Funding carry-forward: ค่า funding ที่เห็นที่เวลา tau ใช้ได้ตั้งแต่แท่งถัดไป ห้ามเติมย้อนหลังจากค่าใหม่ (p.19, p.34)
- Cap โดยโครงสร้าง: ถ้าสัญญาณทำให้ position เกิน leverage หรือ notional cap engine จะลดขนาดเทรดลงให้พอดี ไม่ปฏิเสธเทรด (p.35)
- ข้อมูลต้องต่อเนื่อง: ไม่ interpolate หรือ forward-fill แท่งที่หาย พบช่องว่างเกินเกณฑ์ (ปกติ 0) pipeline หยุด (p.31-32)
การแยกส่วนแบบ expert system
AutoQuant เรียกตัวเองว่า expert-system-like ในความหมายของกฎที่เขียนชัดและตรวจสอบได้ ไม่ได้อ้างว่าคิดค้นการให้เหตุผลเชิงสัญลักษณ์ (p.8)
| ส่วน | ใน AutoQuant | ผลลัพธ์ |
|---|---|---|
| Knowledge base | STRICT4H, funding, ต้นทุน, นโยบายคัดกรอง | กฎที่กัน look-ahead (p.9) |
| Inference engine | TPE + double screening | config ที่เสถียร พร้อมผลตรวจ (p.9) |
| Explanation interface | ไฟล์ machine-readable, invariant | ไฟล์สร้างตารางซ้ำได้ (p.9) |
| Governance overlay | Live guard + ตรวจ invariant | สัญญาณเฝ้าระวังขณะรัน (p.9) |
บทบาทของแต่ละ window
| Window (BTC) | ช่วง | ใช้ทำอะไร |
|---|---|---|
| Training | 2019-09-08 ถึง 2021-01-01 | Stage I เท่านั้น (p.30) |
| Validation | 2021-01-01 ถึง 2023-01-01 | Stage II กรองและเลือก (ใช้ซ้ำ) (p.30) |
| Long-horizon | 2019-09-08 ถึง 2025-10-14 | DSR และ stress test ไม่ใช้เลือก (p.30) |
| Blind post-ETF | 2024-01-01 ถึง 2025-10-14 | ไม่ใช้ปรับหรือเลือกเลย (p.30) |
ช่วง 2023 ของ BTC ถูกเว้นไว้เพื่อแยก window เลือกออกจาก hold-out (p.37)
Important Validation ไม่ใช่ out-of-sample เต็มรูป เพราะ Stage II ใช้มันเลือก candidate ตัวเลขบน validation จึงอ่านเป็นการตรวจความทนทาน ส่วน window เดียวที่ไม่เคยถูกใช้คือ blind hold-out (p.30, p.52)
How it works
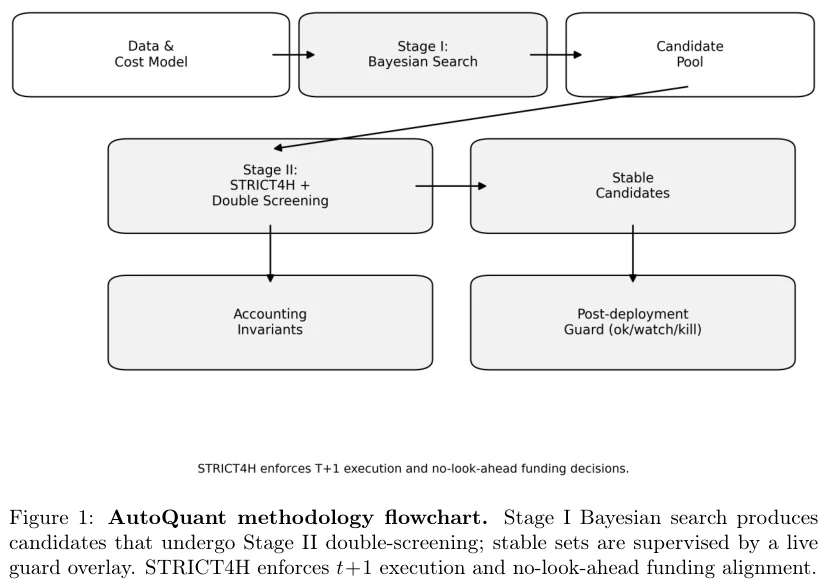
รูปที่ 1 (p.10): ข้อมูลและโมเดลต้นทุน เข้า Stage I ได้ candidate pool ส่งเข้า Stage II ได้ stable candidates ซึ่งอยู่ภายใต้ guard ส่วน Stage II ต่อกับ accounting invariants
1. ตั้งโมเดลต้นทุนก่อนค้นหา
ผลสุทธิต่อแท่งคือ (p.20, p.22)
r_net(t) = r_raw(t) - C_fee(t) - C_slip(t) - C_fund(t)
r_raw(t) = pi(t) * r_mkt(t)          # pi(t) มาจากสัญญาณของแท่ง t-1
C_fee(t)  = |d_pi(t)| * f_eff        # f_eff = taker fee (maker ratio = 0)
C_slip(t) = |d_pi(t)| * s            # s = slippage_bps / 10000 * multiplier
C_fund(t) = pi(t) * fr_8h(t) * (dh / 8)    # dh = 4 ชั่วโมง
| สถานการณ์ต้นทุน | Fee (bps) | Slippage (bps) | Funding |
|---|---|---|---|
| Baseline | 4 | 2 | จริง + fallback |
| Funding-off | 4 | 2 | ปิด |
| Pessimistic 2x | 8 | 4 | จริง + fallback |
| Pessimistic 3x | 12 | 6 | จริง + fallback |
Fallback ของ funding คือ 1 bps ต่อ 8 ชั่วโมง ใช้เมื่อไม่มีชุดข้อมูลจริง (p.34) ไม่มี maker rebate ในโมเดล จึงเอนไปทางประเมินต้นทุนสูงกว่าจริง (p.34)
2. กำหนดครอบครัวสัญญาณ (ไม่สร้างสัญญาณใหม่)
สัญญาณถูกมองเป็น black box ที่ map ข้อมูลกับ hyperparameter เป็น {-1, 0, +1} ใน case study ใช้ momentum จาก EMA เร็วและช้า ผสมกับ mean-reversion (p.12)
m(t)  = 0.5 * (1 + tanh((EMA_fast - EMA_slow) / (sigma(theta) * EMA_slow)))
C(t)  = w_mom * m(t) + (1 - w_mom) * a(t)        # a(t) = max ของ sub-score mean-reversion
signal = +1 if C >= tau_long ; -1 if C <= 1 - tau_short ; 0 otherwise
tau_long(t) = tau_base + kappa * max(|fr(t)| - theta_bias/10000, 0)
ถ้า kappa = 0 กลไกปรับ threshold ตาม funding จะปิด (p.13) ช่วงค้นหาหลัก เช่น ema_fast 6-32, ema_slow 20-96, bb_period 10-30, min_hold_bars 1-6 และพารามิเตอร์ risk หลายตัวที่ค่าเริ่มต้น 0 คือปิด (Table 3, p.17)
3. Stage I: Bayesian search
- ใช้ TPE (Optuna) บน training window ใต้ต้นทุน baseline (p.14-15)
- เป้าหมายเดียวคือ CAGR สุทธิ rann = (1 + Rtot)^(AF/N) - 1 โดย AF = 2190 (6 แท่งต่อวัน x 365) (p.14)
- ไม่ใส่เงื่อนไข drawdown ใน Stage I เพื่อไม่ฝังความชอบด้านความเสี่ยงลงใน sampler (p.15)
- เก็บ candidate ที่คะแนนสูงสุด K ตัวเป็น pool (p.11)
TPE ถูกเลือกเพราะพื้นที่ค้นหามีทั้งค่าต่อเนื่อง ค่าไม่ต่อเนื่อง และบล็อกที่เปิดปิดได้ (p.15) sampler สลับเป็นตัวอื่นได้โดยไม่แตะกฎ execution (p.15)
4. Stage II: double screening
ไม่ optimize ซ้ำ เพียงกรอง pool เดิมด้วยสองสาย (p.20)
- Held-out window: ประเมินทุก candidate บน rolling window ยาว 2000 แท่ง เลื่อนทีละ 500 แท่ง ไม่ train ใหม่ในแต่ละ window
- Cost scenario: ตาราง taker_bps {3, 4, 6} x fund_mult {0.5, 1.0, 1.5} รวม 9 สถานการณ์ และ stress เพิ่ม fee กับ slippage 2x/3x กับกรณีปิด funding
5. กฎเลือก stable candidate
รวมค่าทุกสถานการณ์ต้นทุน แล้วกรองด้วยเกณฑ์ที่ตั้งไว้ล่วงหน้า (Table 8, p.23)
| สถิติ | เกณฑ์ | หน้าที่ |
|---|---|---|
| mean_monthly_true | >= 0.005 | ผลตอบแทนขั้นต่ำ |
| min_monthly_true | >= 0.0 | พื้นขาลงของสถานการณ์แย่สุด |
| maxDD_mean | <= 0.30 | เพดาน drawdown |
| switch_density_mean | <= 0.12 | เพดาน turnover หรือความเปราะบาง |
ผู้ผ่านเกณฑ์ถูกเรียงตาม mean_monthly_true จากมากไปน้อย แล้ว maxDD_mean จากน้อยไปมาก เลือก K = 5 (p.23) ค่ารายเดือนคำนวณจากผลตอบแทนรวมรายเดือนของ r_net (p.22)
6. Accounting invariants และ Live guard
- Invariant: exposure, fee, slippage, funding สุทธิ และ PnL ต้อง reconcile ภายใน tolerance ระหว่าง backtest, paper trading และ log การรันที่ใช้ code path เดียวกัน (p.22-23)
- Guard: เฝ้าผลตอบแทน 30 และ 90 วัน, drawdown จากจุดสูง, ขาดทุนรายวันสูงสุด และความถี่เทรด แล้วออกคำสั่ง ok, watch หรือ kill โดย kill จะปิด position และอาจหยุดเทรดจนกว่าจะสั่งต่อด้วยมือ (p.23-24)
- สถานะหลักฐาน: guard เป็นแบบแผนที่มีหลักฐานจำกัดเฉพาะ config ไม่มีสถิติ track record ระยะยาว (p.24) ค่าเกณฑ์ที่ทำให้เป็น watch หรือ kill ไม่ปรากฏในข้อความที่สกัดได้
7. ตรวจ multiple testing
- DSR: จำนวน trial ที่มีผล Ntotal อยู่ระหว่าง Nopt x Nwindows ถึง Nopt x Nwindows x Nscen = 40 x 9 = 360 ถึง 40 x 9 x 9 = 3,240 (p.24)
- CSCV/PBO: แบ่งผลรายเดือนเป็น 8 ช่วง 70 combinatorial splits บน top-40 ของ Stage I (p.25)
Evidence
ตัวเลขด้านล่างมาจากตารางที่รายงานโดยตรง ยกเว้นแถวที่ระบุว่าคำนวณเอง ทุก config ต่างกันตามตาราง จึงห้ามเทียบข้ามตารางโดยไม่ดูว่าใช้ config ไหน
ต้นทุนทำให้ผลพองเท่าไร
Config stress test หนึ่งตัว บน BTC core sample (2019-09-08 ถึง 2021-12-31) CAGR เป็นทศนิยม 2.726 หมายถึง 272.6% ต่อปี (p.45)
| Variant | CAGR | Sharpe | MaxDD | Trades |
|---|---|---|---|---|
| Rigorous (fee + slippage + funding) | 2.726 | 2.049 | 0.265 | 636 |
| Standard (fee อย่างเดียว) | 4.308 | 2.506 | 0.262 | 636 |
| Naive (ไม่มีต้นทุน) | 5.225 | 2.711 | 0.260 | 535 |
คำนวณเอง: CAGR ของ Standard สูงกว่า Rigorous 1.58 เท่า และ Naive สูงกว่า 1.92 เท่า การผ่อน cap ของ leverage ไม่เปลี่ยนตัวเลขใน snapshot นี้ (p.44-45)
Baseline เดี่ยว แยกตาม window
Baseline ที่ freeze หลัง Stage I ผลตอบแทนพลิกจากบวกเป็นลบเมื่อเข้า validation (Table 14, p.39)
| Window | CAGR | MaxDD | Sharpe | Trades |
|---|---|---|---|---|
| Training | +16.59% | 0.6041 | 0.5233 | 1,027 |
| Validation | -56.43% | 0.9174 | -0.5913 | 1,549 |
| Long | -24.09% | 0.9536 | -0.0738 | 4,814 |
One-stage เทียบ two-stage (BTC)
ผลตอบแทนรายเดือนแบบ geometric เป็นทศนิยม (Table 15, p.41)
| Window | Method | Monthly geom | Sharpe | MaxDD | Trades |
|---|---|---|---|---|---|
| Training | One-stage | 0.222 | 3.164 | 0.283 | 548 |
| Training | Two-stage | 0.145 | 2.388 | 0.265 | 485 |
| Validation | One-stage | 0.051 | 1.238 | 0.318 | 423 |
| Validation | Two-stage | 0.038 | 1.070 | 0.231 | 348 |
| Post-ETF | One-stage | 0.023 | 0.845 | 0.220 | 259 |
| Post-ETF | Two-stage | 0.016 | 0.664 | 0.196 | 223 |
| Post-ETF | Buy-and-hold | 0.048 | 1.405 | 0.307 | - |
Buy-and-hold เหนือทั้งสอง config ใน post-ETF ส่วน validation buy-and-hold ติดลบ (-0.024) และ MaxDD 0.771 (p.41)
Bootstrap แบบ moving block (block 3 เดือน) ของผลต่างรายเดือน two-stage ลบ one-stage บน validation ได้ -0.016 ช่วงเชื่อมั่น 95% คือ [-0.040, 0.008] ซึ่งคร่อมศูนย์ (Table 16, p.43)
สินทรัพย์อื่น
ตาราง 19 และ 20 (p.46, p.48) ใช้ครอบครัวสัญญาณเดียวกันและต้นทุนที่เข้มกว่าสำหรับ mid-cap
| ผลเทียบ two-stage กับ one-stage | จำนวน window |
|---|---|
| MaxDD ต่ำกว่า | 10 จาก 12 (ยกเว้น ETH validation และ SOL validation) |
| ผลตอบแทนรายเดือนต่ำกว่า | 10 จาก 12 (ยกเว้น SOL validation และ SOL post-2024) |
นับเองจาก Table 15, 19, 20 AVAX เห็นต่างสุด: MaxDD one-stage 0.795 กับ two-stage 0.055 บน training (p.48)
Execution semantics และการตรวจภายใน
| การตรวจ | ผล | หน้า |
|---|---|---|
| t+1 เทียบ t+0 (BTC 2022) | CAGR -0.221 เทียบ -0.264 | p.61 |
| t+0 เทียบ t+1 บน top-30 trials | uplift มัธยฐาน -0.018, บวกเพียง 36.7% | p.61 |
| Replay ใน Backtrader (raw return) | ต่างสูงสุด 2.75e-6, correlation 1.000 | p.61 |
| Invariant audit BTC และ ETH | ผลต่างของ signal, exposure, fee, slippage, funding = 0 | p.23 |
| Funding gate (trial 109) | training 0.089 เทียบ 0.067, validation เท่ากัน | p.20 |
Drawdown-bucket risk budgeting
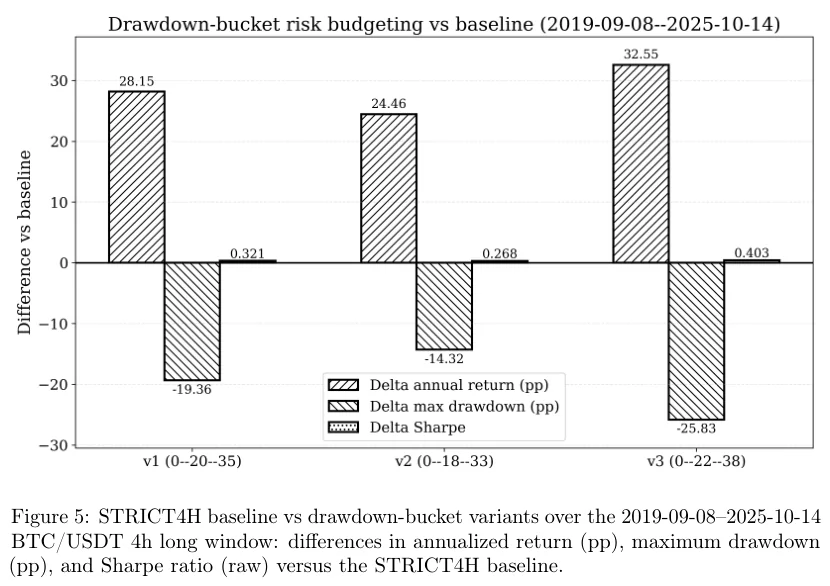
ลด exposure ใน bucket ที่ drawdown ลึกขึ้น เทียบ baseline บน window ยาว (Table 22, p.49)
| Variant | CAGR | MaxDD | Sharpe |
|---|---|---|---|
| Baseline (Table 14) | -24.09% | 0.9536 | -0.074 |
| v1 (0-20-35) | +4.06% | 0.760 | 0.247 |
| v2 (0-18-33) | +0.37% | 0.810 | 0.194 |
| v3 (0-22-38) | +8.46% | 0.695 | 0.329 |
Diagnostic overfitting
| ตัวชี้วัด | ค่า | ที่มา |
|---|---|---|
| PBO | 0.586 (8 ช่วง, 70 splits, top-40) | p.25 |
| DSR | ไม่ปฏิเสธ Sharpe จริง = 0 | p.24-25 |
| Stage I best-so-far | 0.1172 ที่ 40 trials, 0.1590 ที่ 100-120 | p.18 |
Figures
| รูป | เนื้อหา | ข้อสังเกต |
|---|---|---|
| รูปที่ 1 (p.10) | ผังขั้นตอนของ pipeline | ดูในหัวข้อ How it works |
| รูปที่ 2 (p.33) | CAGR ของ baseline แยก window | 16.59%, -56.43%, -24.09% ตรงกับ Table 14 |
| รูปที่ 3 (p.42) | Equity curve one-stage เทียบ two-stage แกน log | อ่านคร่าว ๆ one-stage ราว 100 เท่า, two-stage ราว 25 เท่า ถึงต้นปี 2023 |
| รูปที่ 4 (p.47) | ETH-trained config บน ETH และ BTC | CAGR 0.44% และ -0.17%, MaxDD 15.0% และ 8.9% |
| รูปที่ 5 (p.50) | ผลต่างของ risk-budget เทียบ baseline | ตรงกับ Table 22 |
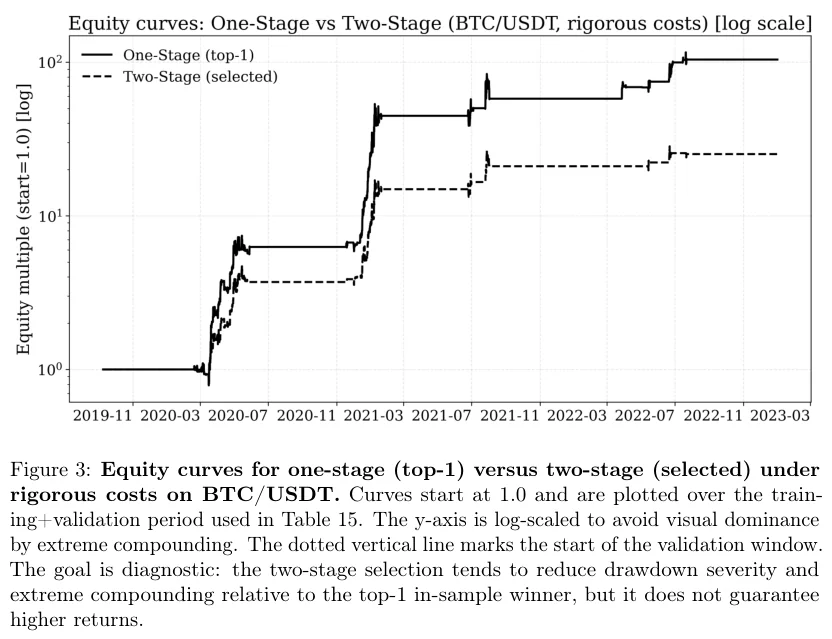
รูปที่ 3: เส้นราบยาวหมายถึงช่วงที่ไม่มี position ค่าจากแกน log เป็นการอ่านด้วยสายตา ไม่ใช่ตัวเลขที่ระบุ
Critical analysis
แยกข้อเท็จจริง ความเห็น และการตีความ
| ประเภท | เนื้อหา |
|---|---|
| ข้อเท็จจริงจากตาราง | Cost ladder 2.726, 4.308, 5.225; PBO 0.586; MaxDD ต่ำกว่าใน 10 จาก 12 window |
| ความเห็นที่ระบุเอง | Stage II มีค่าเพราะตรวจความเปราะบาง ไม่ใช่เพราะเพิ่มผลตอบแทน (p.41, p.43) |
| สมมติฐานของ design | ใช้ validation ซ้ำได้ถ้าเรียกว่า validation-style; threshold คือนโยบาย (p.43) |
| การตีความของเรา | ผลต่างรายเดือนของสองวิธียังแยกจากศูนย์ไม่ได้ (CI คร่อมศูนย์) |
| การตีความของเรา | t+0 ไม่พองผลใน snapshot นี้ จึงยังไม่มีหลักฐานเชิงปริมาณว่า t+1 กันผลพอง |
| การตีความของเรา | PBO > 0.5 แปลว่าผู้ชนะใน sample มักแย่นอก sample (นิยามทั่วไป ควรตรวจซ้ำ) |
จุดที่อ่านแล้วไม่ลงรอยหรือยังไม่ชัด
- Baseline ที่บอกว่าเป็น "production-oriented" ขาดทุน 24.09% ต่อปี และ MaxDD 0.95 บน window ยาว (p.38-39) ส่วน config ในตารางอื่นให้ผลดีกว่ามาก จึงเทียบข้ามตารางไม่ได้
- Threshold ที่เข้มกว่าไม่ได้ให้ MaxDD ต่ำกว่า: เพดาน 0.25 เลือก trial 87 ซึ่ง MaxDD บน validation = 0.386 เทียบกับเพดาน 0.30 ที่ได้ 0.231 (Table 17, p.44) เพราะตัวกรองวัดค่าเฉลี่ยข้ามสถานการณ์บน training+validation ไม่ใช่ validation เดียว
- ผล validation ที่เลือกเปลี่ยนตาม threshold: CAGR 0.332-1.058, Sharpe 0.844-1.667, MaxDD 0.209-0.386 จาก 27 นโยบาย (p.43) ผลจึงมาจากการเลือก threshold พอ ๆ กับการเลือก config
- Random search ใน Table 5 ให้ -1.0 ที่ 10 trials และค่าเดียวกัน (-0.7832 +- 0.4848) ที่ 20, 40 และ 60 trials จำนวน seed ไม่ระบุ จึงอ่านความแรงของ TPE จากตารางนี้ยาก (p.18)
- Funding gate ไม่เปลี่ยนผลบน validation (0.004 และ MaxDD 0.365 เท่ากันทั้งคู่) ผลบวกมีเฉพาะ training และเป็น trial เดียว (p.20)
- Cross-asset (Table 21, p.48): CAGR 0.44% บน ETH และ -0.17% บน BTC ด้วย 3,100 และ 3,403 เทรด ซึ่งใกล้ศูนย์ ข้อความเรียกว่า "robustness" แต่ตัวเลขไม่ได้แสดงกำไร หน่วยในตารางคือ % จึงควรระวังเวลาเทียบกับตารางที่ใช้ทศนิยม
- Risk budgeting เปลี่ยนผล -24.09% เป็น +0.37% ถึง +8.46% และ MaxDD ยังสูง 0.695-0.810 (p.49) รายงานบน window ยาวเดียว ไม่มี hold-out แยก
- ตารางเทียบกับเฟรมเวิร์กอื่น (Table 1, p.6) ประเมินจากเอกสารและการใช้งานทั่วไป ไม่ใช่การทดสอบ
Risks and limits
Warning ผลตอบแทนทั้งหมดมาจาก backtest บัญชีเล็กภายใต้ต้นทุนเชิงเส้น ไม่มี market impact และ capacity ค่า CAGR ที่เกิน 1.0 (100% ต่อปี) เป็นตัวชี้วัดความไวต่อต้นทุนและ window ไม่ใช่ความสามารถทำกำไรที่ขยายได้ (p.7, p.56)
| ข้อจำกัด | รายละเอียด |
|---|---|
| ขอบเขตหลักฐาน | ครอบครัวสัญญาณเดียว (STRICT4H) บน 4 สัญญาณที่สภาพคล่องสูง (p.7) |
| Survivorship | ไม่ศึกษา delisting หรือสัญญาที่เพิ่งเปิด (p.55) |
| Black swan | ไม่แยก event เช่น LUNA หรือ FTX เป็น stress test (p.55) |
| Benchmark ภายนอก | ไม่เทียบเครื่องมืออื่นใน semantics เดียวกัน ทำแค่ replay ใน Backtrader (p.55) |
| Optimizer | เทียบ TPE กับ random เท่านั้น ไม่เทียบ evolutionary หรือ BO อื่น (p.55-56) |
| ต้นทุน | เชิงเส้นตาม turnover ไม่มี square-root impact (p.56) |
| Guard | ตรวจ structural break ทางอ้อมผ่าน drawdown ไม่มีการทดสอบทางสถิติ (p.53) |
| ข้อมูล | ไม่ชัดว่า OHLCV เป็น last-trade, mark หรือ index ในบางสถานที่ (p.56) |
| Compute | ใช้ CPU อย่างเดียว ใช้เวลาหลายชั่วโมงถึงไม่ถึงหนึ่งวันต่อสินทรัพย์ (p.19) |
| โมเดลสัญญาณ | ยังไม่รองรับโมเดลซับซ้อนที่ต้องจัดการ train และ GPU (p.56-57) |
การทดลอง ATR guard บนแท่ง 1 ถึง 60 นาทีไม่พบการปรับปรุงที่ชัดเจนหลังหัก fee และ slippage (p.62) ซึ่งเป็นหลักฐานเสริมของกรอบ 4 ชั่วโมง ไม่ใช่ผลหลักที่รายงาน
Applying it
ขั้นตอน 1-6 ปรับจากโปรโตคอลห้าข้อที่ระบุไว้ (p.51) ส่วนเกณฑ์ตรวจและข้อผิดพลาดที่พบบ่อยเป็นข้อเสนอเพิ่มของเรา
ขั้นตอน
- ตรวจข้อมูลต่อเนื่องและกำหนดโปรไฟล์ต้นทุนกับ cap ให้ตายตัวก่อนเริ่มค้นหา
- ตรึง execution: t+1, funding carry-forward, cap ที่บังคับเมื่อสร้าง order
- รัน Bayesian search บน training window เท่านั้น ตั้งงบ trial ล่วงหน้า
- ประเมิน candidate pool เดิมบนหลาย window และกริดต้นทุน โดยไม่ปรับพารามิเตอร์ซ้ำ
- กรองด้วย threshold ที่เขียนไว้ก่อนเห็นผล เรียงตามเกณฑ์ที่ประกาศ
- อ่านผลร่วมกับ DSR และ PBO ตรวจ invariant ระหว่าง backtest กับ replay แล้วจึงตั้ง guard
เกณฑ์ตรวจ (ข้อเสนอเพิ่มเติม)
| ตรวจอะไร | ผ่านเมื่อ |
|---|---|
| Invariant | ผลต่าง signal และ exposure เท่ากับศูนย์ทุกแท่ง |
| Cost ladder | รู้ตัวเลข rigorous, fee-only และ zero-cost ของ config เดียวกัน |
| Window | ระบุว่า window ไหนถูกใช้เลือก และไม่เรียกมันว่า out-of-sample |
| Threshold | ลองหลายค่าแล้วผลไม่เปลี่ยนมากจนผู้ชนะสลับ |
| เทียบ buy-and-hold | แสดงทั้ง return และ MaxDD ทุก window |
| Hold-out | ไม่เคยเปิดดูก่อนล็อก config |
ข้อผิดพลาดที่พบบ่อย (ข้อเสนอเพิ่มเติม)
- รายงานผล validation เป็น out-of-sample หลังใช้มันกรองแล้ว
- เทียบตัวเลขจากต่าง config หรือ window เหมือนเป็นการทดลองเดียว
- เชื่อ CAGR ทศนิยมที่เกิน 1.0 โดยไม่ดู drawdown และ cost ladder
- ปรับ threshold หลังเห็น hold-out
- สรุปว่า guard ปลอดภัยแล้วโดยยังไม่มีเกณฑ์ที่ทดสอบจริง
Recommendation ถ้านำแนวคิดนี้ไปใช้ ให้เริ่มจากสิ่งที่ตรวจสอบได้ถูกที่สุดก่อน: ตรึงกฎ execution และต้นทุน, ทำ cost ladder, ส่งออก ledger รายแท่ง ส่วน Stage II และ PBO ค่อยเพิ่มเมื่อมี pipeline ที่สร้างผลซ้ำได้แล้ว นี่เป็นคำแนะนำของเรา ไม่ใช่ข้อความที่ระบุไว้
Checklist
สถานะ: 🟢 ผ่าน, 🟡 บางส่วน, 🔴 ไม่ผ่าน, ⚪ ยังไม่ตรวจ
| รายการ | สถานะ |
|---|---|
| มี t+1 และ funding carry-forward ในโค้ด backtest | ⚪ |
| fee สองขา, slippage, funding และ cap อยู่ใน backtest เดียวกัน | ⚪ |
| แท่งข้อมูลต่อเนื่อง และ funding ไม่ถูกเติมย้อนหลัง | ⚪ |
| งบ trial และ threshold ตั้งก่อนเห็นผล | ⚪ |
| ผลของ window ที่ถูกใช้ซ้ำถูกเรียกชื่อให้ถูก | ⚪ |
| มี cost ladder ของ config ที่เลือก | ⚪ |
| มี DSR หรือ PBO หรือตัวตรวจ multiple testing อื่น | ⚪ |
| ledger รายแท่งส่งออกได้ และ replay ตรงกัน | ⚪ |
| เทียบ buy-and-hold ทั้ง return และ MaxDD | ⚪ |
Glossary
| คำ | ความหมาย |
|---|---|
| Perpetual futures | สัญญา futures ไม่มีวันหมดอายุ ราคาถูกยึดกับ spot ด้วย funding |
| Funding rate | เงินที่ฝั่ง long และ short จ่ายกันเป็นรอบ ๆ (ในงานนี้ทุก 8 ชั่วโมง) |
| Look-ahead bias | ใช้ข้อมูลที่ยังไม่มีตอนตัดสินใจ |
| STRICT4H | กฎ execution แท่ง 4 ชั่วโมง: t+1 กับ funding ห้ามย้อนหลัง |
| Double screening | กรอง candidate เดิมข้าม window และสถานการณ์ต้นทุน |
| Notional | มูลค่าเต็มของ position (ราคา x ขนาด) ต้นทุนส่วนใหญ่คิดจากค่านี้ |
| Leverage | สัดส่วน notional ต่อทุน 5x = ถือได้สูงสุด 5 เท่าของทุน |
| Slippage | ส่วนต่างระหว่างราคาที่คาดกับราคาที่ได้จริงตอนส่ง order |
| Taker / Maker | Taker รับราคาที่มีอยู่ทันที (จ่าย fee สูงกว่า) Maker ตั้ง order รอ |
| Turnover | ขนาดการเปลี่ยน position รวม ต้นทุน fee และ slippage คิดตามค่านี้ |
| Hold-out | ช่วงข้อมูลที่กันไว้ไม่ใช้ปรับหรือเลือก ใช้ตรวจครั้งท้าย |
| In-sample / Out-of-sample | ช่วงที่ใช้เลือก config / ช่วงที่ไม่เคยถูกใช้เลือก |
| Switch density | สัดส่วนแท่งที่ position เปลี่ยน |
| Live guard | ตัวเฝ้า performance ที่ออก ok, watch หรือ kill |
Page map
| หัวข้อในหน้านี้ | หน้า |
|---|---|
| ภาพรวม ขอบเขต ข้อสรุป | p.1-7 |
| Methodology, สูตร, Stage I และ II | p.7-25 |
| งานที่เกี่ยวข้อง | p.25-28 |
| ข้อมูลและโมเดลต้นทุน | p.28-35 |
| สถาปัตยกรรมระบบ | p.35-36 |
| ผลการทดลอง (Table 13-22, รูปที่ 3-5) | p.36-50 |
| Discussion และ limitations | p.51-57 |
| Conclusion | p.57-58 |
| Reproducibility และ semantics check | p.59-62 |
| Reference | p.63-67 |
Sources
- Journal of Computational Finance (2017): วิธี CSCV และ Probability of Backtest Overfitting
- Journal of Portfolio Management (2014): Deflated Sharpe Ratio
- Advances in Neural Information Processing Systems (2011): TPE สำหรับ hyper-parameter search
- ACM SIGKDD (2019): Optuna
- Annals of Statistics (1989): moving block bootstrap
ตัวย่อที่ใช้ในหน้านี้
หน้านี้ใช้ตัวย่อทั้งหน้า ตารางนี้อธิบายตัวย่อทุกตัวที่ใช้ในหน้านี้ เรียงตามกลุ่ม
ตัวชี้วัดผลลัพธ์
| ตัวย่อ | ชื่อเต็ม | คืออะไร | อ่านค่าอย่างไร |
|---|---|---|---|
| CAGR | Compound Annual Growth Rate | ผลตอบแทนทบต้นต่อปี (p.14) | ทศนิยม: 2.726 = 272.6% ต่อปี, -0.22 = ขาดทุน 22% |
| MaxDD | Maximum Drawdown | ระยะที่ equity ลดลงมากสุดจากจุดสูงสุด (p.14) | สัดส่วน 0-1: 0.30 = เคยลดลง 30% |
| DD | Drawdown | การลดลงจากจุดสูงสุดล่าสุด ณ เวลาหนึ่ง | ใช้ตั้งเพดานและเฝ้าระวัง |
| Sharpe | Sharpe ratio | ผลตอบแทนส่วนเกินต่อหน่วยความผันผวน (p.39) | มากกว่า = ดีกว่า, ติดลบ = แย่กว่าความเสี่ยงต่ำ |
| PnL | Profit and Loss | กำไรขาดทุน | บวก = กำไร |
| AF | Annualization Factor | จำนวนแท่ง 4 ชม. ต่อปี = 6 x 365 = 2,190 (p.14) | ใช้แปลงผลต่อแท่งเป็นต่อปี |
ตัวตรวจ overfitting และสถิติ
| ตัวย่อ | ชื่อเต็ม | คืออะไร | อ่านค่าอย่างไร |
|---|---|---|---|
| PBO | Probability of Backtest Overfitting | โอกาสที่ผู้ชนะใน sample อันดับแย่นอก sample (p.25) | 0.586 = สูง ค่าเกิน 0.5 น่ากังวล (นิยามทั่วไป) |
| CSCV | Combinatorial Symmetric Cross-Validation | แบ่งข้อมูลเป็นช่วง แล้วสลับ train/test ทุกแบบ ใช้คำนวณ PBO | งานนี้ 8 ช่วง 70 splits (p.25) |
| DSR | Deflated Sharpe Ratio | Sharpe ที่ปรับลดตามจำนวนครั้งที่ลองเลือก (p.24) | ไม่ปฏิเสธศูนย์ = แยกจากโชคไม่ได้ |
| CI | Confidence Interval | ช่วงที่ค่าจริงน่าจะอยู่ ที่ระดับความเชื่อมั่นหนึ่ง | CI 95% คร่อมศูนย์ = แยกจากศูนย์ไม่ได้ |
ตัวย่อด้านวิธีและข้อมูล
| ตัวย่อ | ชื่อเต็ม | คืออะไร | อ่านค่าอย่างไร |
|---|---|---|---|
| TPE | Tree-structured Parzen Estimator | ตัวเลือกพารามิเตอร์แบบ Bayesian เรียนรู้จากผลที่ผ่านมา (p.15) | Stage I ใช้ 40 หรือ 120 trials |
| BO | Bayesian Optimization | ค้นหาพารามิเตอร์โดยใช้ผลที่ผ่านมาชี้ทางต่อ | TPE เป็นหนึ่งในวิธี BO |
| Stage I / II | ขั้นที่ 1 / ขั้นที่ 2 | I = ค้นหาบน training, II = กรอง candidate เดิม (p.19) | II ไม่ optimize ซ้ำ |
| t+1 / t+0 | - | สัญญาณมีผลแท่งถัดไป / แท่งเดียวกัน (p.19) | t+0 ไม่ถูกต้องเชิงหลักการ |
| OHLCV | Open High Low Close Volume | แท่งราคา: เปิด สูง ต่ำ ปิด และปริมาณ (p.31) | งานนี้แท่งละ 4 ชั่วโมง |
| EMA | Exponential Moving Average | ค่าเฉลี่ยเคลื่อนที่ที่ให้น้ำหนักข้อมูลล่าสุดมากกว่า (p.12) | fast 6-32 แท่ง, slow 20-96 แท่ง |
| ATR | Average True Range | ค่าเฉลี่ยช่วงราคาวิ่ง ใช้ตั้ง stop-loss และ take-profit | ค่า 0 = ปิดกลไกนี้ (p.17) |
| ETF | Exchange-Traded Fund | งานใช้ "post-ETF" เรียก window ตั้งแต่ 2024-01-01 (p.30) | เป็นแค่ชื่อ window |
| CPU / GPU | - | หน่วยประมวลผลทั่วไป / การ์ดจอ | งานนี้ใช้ CPU อย่างเดียว (p.19) |
หน่วยและสินทรัพย์
| ตัวย่อ | ชื่อเต็ม | คืออะไร | อ่านค่าอย่างไร |
|---|---|---|---|
| bps | basis points | 1 bps = 0.01% | 4 bps = 0.04% ของ notional |
| USDT | Tether | stablecoin ผูกกับดอลลาร์ ใช้เป็นสกุลวัดกำไร | BTC/USDT = คู่ซื้อขายบิตคอยน์ |
| BTC, ETH | Bitcoin, Ethereum | สินทรัพย์ที่ทดสอบ | - |
| SOL, AVAX | Solana, Avalanche | สินทรัพย์ mid-cap ที่ทดสอบ (p.46) | ต้นทุนในงานเข้มกว่า BTC |
| LUNA / FTX | - | ชื่อเหตุการณ์สุดขั้วที่งานยกเป็นตัวอย่าง (p.55) | งานไม่ได้ทดสอบแยก |
| AutoQuant, STRICT4H | - | ชื่อกรอบทั้งชุด และชื่อกฎ execution แท่ง 4 ชม. | ดู Core concepts |
| ACM SIGKDD | Association for Computing Machinery, KDD group | ชื่อการประชุมวิชาการ (อยู่ใน Sources) | - |
| [ASSUMPTION] | - | ป้ายของเรา หมายถึงสมมติฐานที่ยังไม่ยืนยัน | อ่านเป็นข้อสมมติ ไม่ใช่ข้อเท็จจริง |
แถวที่มาจากความรู้ทั่วไป ไม่ใช่นิยามที่งานให้ไว้: bps, USDT, สัญลักษณ์เหรียญ, EMA, ATR, CI, BO, CPU/GPU และคำอธิบาย Sharpe
Summary
AutoQuant ไม่ใช่กลยุทธ์ใหม่ และไม่ได้พิสูจน์ว่ามี alpha ถาวร (p.1-2) มันเป็นชุดกฎกับขั้นตอนที่ล็อก execution, funding และต้นทุนไว้ก่อน แล้วเลือกพารามิเตอร์ของสัญญาณที่กำหนดไว้แล้วภายใต้กฎเหล่านั้น พร้อมส่งออกไฟล์ที่ตรวจย้อนได้ทุกแท่ง (p.5-7)
- ปัญหา: backtest ของ perpetual futures พองง่ายเมื่อมองข้าม fee, funding, slippage และ cap ของ leverage หรือเมื่อใช้ window เดิมซ้ำตอนเลือกพารามิเตอร์ (p.1-2)
- วิธี: Stage I ใช้ Bayesian search (TPE) บน training window, Stage II กรอง candidate เดิมข้ามหลาย window และหลายสถานการณ์ต้นทุนโดยไม่ optimize ซ้ำ (p.19-21)
- ผลที่สำคัญ: ตัดต้นทุนออกแล้ว CAGR ของ config เดียวกันเพิ่มจาก 2.726 เป็น 4.308 (เหลือแค่ fee) และ 5.225 (ไม่มีต้นทุน) (p.45)
- สิ่งที่ Stage II ให้: MaxDD ต่ำกว่า one-stage ใน 10 จาก 12 window ที่รายงาน ไม่ได้ให้ผลตอบแทนสูงกว่า (นับจากตาราง p.41, 46, 48)
- สิ่งที่ยังไม่ผ่าน: PBO = 0.586 และ DSR ไม่ปฏิเสธ Sharpe จริงเป็นศูนย์ แปลว่ายังเสี่ยง overfit สูง (p.25)
| ตัวเลขสำคัญ | ค่า |
|---|---|
| สินทรัพย์ | BTC, ETH, SOL, AVAX perpetual (p.1) |
| ข้อมูล | แท่ง 4 ชั่วโมง ตั้งแต่ 2019-09-08 ถึง 2025-10-14 (BTC) (p.29) |
| ต้นทุนฐาน | taker 4 bps, slippage 2 bps, funding จริง (p.34) |
| ทุนเริ่มต้น และ cap | 10,000 USDT, leverage 5x, notional 50,000 USDT (p.34) |
| งบ Stage I | 40 trials (baseline), 120 trials (ตารางเทียบ) (p.15-16) |
| ขนาด Stage II | 40 candidate x 9 สถานการณ์ต้นทุน = 360 backtest (p.19) |